Я подложил в игру двенадцать багов, а мой ИИ-тестировщик нашёл четыре
Последний год я в свободное время делаю небольшие игры, а последние полгода делаю их вместе с ИИ-агентами, которые пишут код. Код они пишут быстро и так же быстро сообщают, что всё работает. К ноябрю я перестал понимать, каким из их зелёных галочек можно верить.
Поэтому я неделю обвешивал агентов проверками, а потом вернулся и проверил сами проверки.
Заголовок как раз про вторую часть. Я подложил двенадцать багов в сборку (играбельную копию игры) и отдал её QA-агенту, который ищет в играх баги. Он нашёл четыре. Я поправил ему инструкции, передвинул баг, на котором оборвался первый прогон, и запустил ещё раз. Он опять нашёл четыре.
На той же неделе всплыли ещё две вещи. «Слепой» плейтестер, которому не положено ничего знать об игре, запускался внутри проекта, где в файле инструкций были названия игр. А ещё я за одну сессию запустил двадцать-тридцать агентов-исследователей заполнять каталог карточек игр, по одной заметке на игру. Посреди работы у них отвалился веб-поиск, но карточки они писать не перестали. Источником некоторые указывали «знание жанра».
Всё вместе я называю GameStudio. Система работает на Claude Code с моделями Claude Haiku 5.5, Sonnet 5.5 и Opus 5.5, плюс ещё одна модель, Fable 5.2, под единственную задачу по экономике игры. Статья про саму систему, так что игры в ней упоминаются только как материал, на котором я её проверял. Цифры взяты из моего репозитория и из двух журналов, которые в нём ведутся: файла уроков и журналов тикетов, о них ниже.
Что лежит в репозитории
В хранилище Obsidian лежит 1361 Markdown-заметка: всё, что я собрал о рынке из открытых источников, разложенное по играм, механикам, жанрам, источникам, решениям и урокам. Рядом около сорока скриптов, которые собирают данные и запускают проверки. Языковую модель почти ни один из них не вызывает. Исключения: обёртки для генерации картинок, 3D и звука, локальная расшифровка через Whisper и один скрипт, который запускает агента по расписанию.
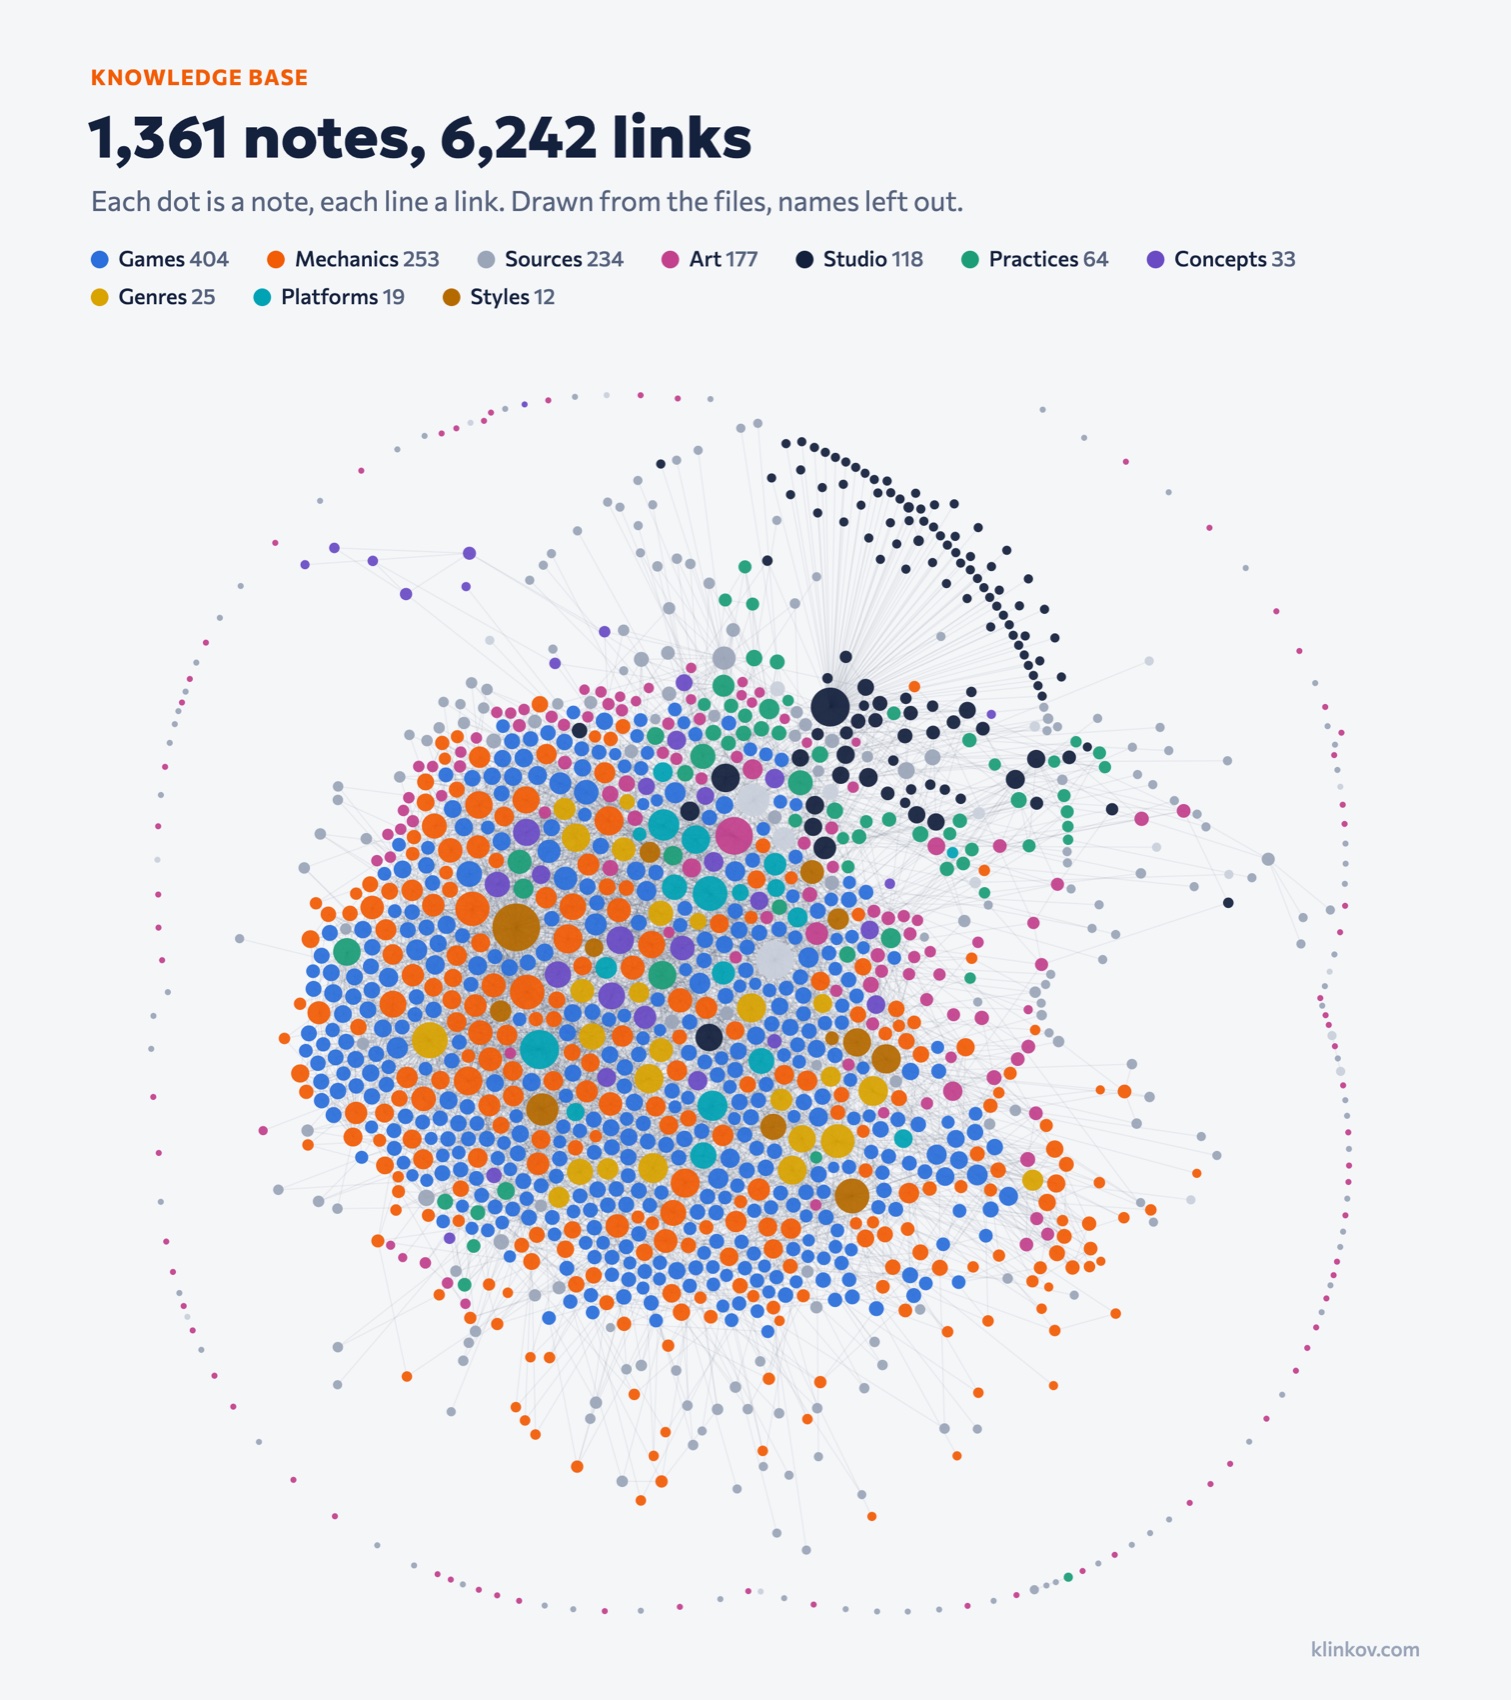
Третья часть, сами агенты: пятнадцать ролей и шестнадцать скиллов. Роль описывает обязанности одного типа агента, скилл содержит инструкцию для одного типа задач, которую можно использовать повторно. Всё это обычные Markdown-файлы, их подгружает Claude Code.
Одновременно из пятнадцати ролей работают немногие. Есть одна ведущая сессия, то есть главный агент, который раздаёт работу (дальше просто лид), при ней до трёх воркеров-кодеров и один ревьюер, а работа только на чтение уходит пачками до шести агентов. Даже трёх кодеров оказалось слишком много для одного общего файла с тестами: его правили все, и он конфликтовал при каждом слиянии. Теперь его трогает только лид.
Состояние хранится в файлах, потому что воркер не видит диалог лида и получает только тикет. Кодер отвечает в жёстком формате, не больше 300 слов: статус done, partial или BLOCKED, изменённые файлы и код возврата каждой команды приёмки. Каждая попытка ложится строкой в журнал тикетов игры, а на всё, что пошло не так, заводится запись с датой в файле уроков. Типичная запись: «Сессия запустила около 16 тяжёлых проверок параллельно, Mac завис (нагрузка 160)». Из неё выросло правило: не больше четырёх-шести тяжёлых процессов на сессию.
QA-агент
QA-агент играет в сборку в headless-браузере. ТЗ ему известно. Шелла у него нет, так что команды он запускать не может. Зато есть инструмент Write, ведь отчёт надо куда-то писать, а значит, от перезаписи какого-нибудь файла его удерживают только инструкции.
Раз за разом он возвращался без багов, и это было бы хорошей новостью, если бы я хоть примерно представлял, способен ли он вообще что-то найти. Тогда я взял копию игры и вписал в неё двенадцать багов, которые включаются тестовым флагом: кнопку «Продолжить» в меню паузы, которая ничего не делает, счётчик с неверным максимумом, розовую полосу через весь экран и ещё девять. На этой копии я и запустил агента. После первого прогона я поменял ему инструкции (продолжать после падения, проверять два размера окна, на каждом экране проходить по чек-листу классов багов), перенёс подложенное падение, на котором он остановился, подальше по ходу игры и запустил второй раз.
| Класс бага | Подложено | Найдено в прогоне 1 | Найдено в прогоне 2 |
|---|---|---|---|
| Падение или исключение | 2 | 2 | 1 |
| Неверное число на экране | 2 | 1 | 1 |
| Визуальный артефакт | 1 | 1 | 0 |
| Тупик | 1 | 0 | 1 |
| Элемент управления, который ничего не делает | 1 | 0 | 1 |
| Текст вылезает за границы | 2 | 0 | 0 |
| Пробел в туториале | 1 | 0 | 0 |
| Утечка памяти | 1 | 0 | 0 |
| Непереведённый текстовый ключ | 1 | 0 | 0 |
| Всего | 12 | 4 | 4 |
В первом прогоне он завёл пять баг-репортов, во втором четыре, и все, кроме одного, совпали с подложенными багами. Этот лишний я так и не проверил, так что долю ложных срабатываний назвать не могу. Репорты у него в основном верные, только их мало.
Часть недобора на совести моего же дизайна теста. В первом прогоне подложенное падение оборвало сессию раньше времени, и шесть багов из двенадцати остались за ним. Во втором подложенный тупик закрыл собой два бага, а ещё три сидели на экране, до которого агент не дошёл. И всё это два прогона одной модели на одной игре.
По полноте (recall), то есть по доле реальных багов, которые агент находит, я целился в 50%, а получил дважды по 33%, причём на тесте, который оба раза прятал от агента пять-шесть багов из двенадцати. Считать 33% его полнотой я бы не стал. Из багов, до которых он мог добраться, он нашёл четыре из шести в первом прогоне и четыре из семи во втором, но это две маленькие выборки, и опираться на них я бы тоже не стал. Утечка памяти вошла в общий счёт, хотя увидеть её агенту нечем. Показал я только то, что данных о высокой полноте у меня нет и что одного падения хватает, чтобы спрятать всё, что идёт после него.
Вторая четвёрка меня не удивила. Я никогда не верил, что агенту можно доверить работу целиком, но тут рядом с этим убеждением впервые появилась цифра, пусть и слабая. Агент пишет «готово» одним и тем же уверенным тоном, сделана работа или нет. Я пользуюсь этими инструментами каждый день, и проверять за ними всё равно приходится. Как видно из раздела про гейты, сам я проверяю не всегда.
Таблица мне нужна ради разбивки по классам. Агент поймал падения и исключения, неверные числа, тупик и элемент управления, который ничего не делает, а визуальный артефакт поймал в одном прогоне из двух. Текст, вылезающий за границы, он пропустил оба раза: в первый раз проверял только один размер окна, во второй исчерпал запас действий раньше, чем дошёл до узкого окна. Утечку памяти он не поймает в принципе, потому что у него нет инструмента, который измеряет память. Тут нужен скрипт, и я его ещё не написал.
После этого я понизил QA до справочной проверки. Его результат печатается в отчёте каждого гейта (гейтом я называю контрольную точку между этапами разработки, о них ниже), но на вердикт не влияет.
Теперь перед каждым настоящим прогоном QA скрипт включает три бага из списка подложенных багов игры, и если агент находит меньше двух, его отчёт аннулируется. Если бы агент находил каждый из трёх независимо с вероятностью одна треть (другой оценки у меня нет), правило аннулировало бы примерно три отчёта из четырёх. На деле исход зависит от того, какие три бага выбраны: четыре класса из девяти не были найдены ни в одном из прогонов, и правило повторяет мою же ошибку всякий раз, когда среди трёх попадается падение, которое прячет остальные. Так что успешная проверка отсекает только халтурный прогон. При первом боевом применении агент не нашёл ни одного из трёх, и отчёт отправился в корзину; свежий агент, которому подсказали, как управлять игрой, нашёл два.
Список багов лежит в папке игры, которую QA-агент может читать, и мешает ему только строчка в инструкциях.
Слепой плейтест и его утечки
Слепой плейтест отвечает на один вопрос: поймёт ли первый экран человек, который ничего об игре не знает. Для меня это быстрая первая проверка онбординга, то есть того, как игра знакомит с собой нового игрока, и не более того: с реальными игроками я его вердикты ни разу не сверял.
В списке инструментов слепого тестера девять действий в браузере и больше ничего. Вот шапка его файла роли, префикс сервера инструментов из названий убран:
name: blind-tester
model: sonnet
tools: browser_take_screenshot, browser_mouse_click_xy, browser_mouse_move_xy,
  browser_mouse_drag_xy, browser_mouse_down, browser_mouse_up,
  browser_mouse_wheel, browser_press_key, browser_type
Он не может читать файлы, запускать код, открывать консоль браузера или уходить на другую страницу. Сборку открывает лид, тестеру достаётся вкладка. Перед этим скрипт вычищает сборку: удаляет source maps, исходники, HTML-комментарии и мета-теги, а заголовок страницы меняет на «Game». В брифе указаны персона (какого игрока изображать), номер эпизода (эпизодом считается один короткий игровой сеанс, не больше 15 действий) и заметки самого тестера с прошлых эпизодов. Названия игры, жанра и цели в брифе нет.
Одна из персон изображает семилетнего ребёнка, который ещё не читает, а играет её модель, которая прочитывает на скриншоте каждое слово. Как это обойти, я не придумал.
В конце эпизода тестер возвращает одну JSON-запись. Вот шаблон из файла роли, в сокращении:
{
  "episode": 1,
  "persona": "семилетний ребёнок, который не читает",
  "game_guess": "что это, по-моему, за игра, одной фразой",
  "goal_understood": true,
  "goal_when": 3,
  "first_success": "что получилось первым и на каком действии",
  "dead_ends": ["действие 5: что пробовал, чего ждал, что произошло"],
  "would_quit": null,
  "unclear": ["чего я не понял на экране"],
  "hint_used": "none"
}
Здесь goal_when означает номер действия, на котором стала понятна цель, а would_quit действие, на котором такой игрок бросил бы игру, или null. В JSON записано то, что тестер рассказывает о себе сам, и этой части я доверяю меньше всего. Тайминги берутся из событий, которые сама игра шлёт в тестовый стенд: цель увидена, первый успех, уровень пройден. Это секунды реального времени от загрузки страницы, и в них входит время, пока модель думает, так что десять секунд модели и десять секунд ребёнка не одно и то же. Честнее было бы считать в действиях, тем более что номер действия в записи уже есть.
На игрушечной игре один эпизод из восьми вызовов инструментов израсходовал 18 120 новых токенов Sonnet (новых, то есть не прочитанных из кэша). Первый настоящий прогон, три персоны и восемь эпизодов на всех, израсходовал около 330 000, потому что настоящие эпизоды длиннее игрушечного.
Пороги прохождения такие: цель понята не позже чем за 10 секунд, первый успех не позже чем за 60, не больше одной подсказки за пять минут. Настоящий прогон уложился во все: у каждой персоны оба события наступили примерно через девять секунд после загрузки страницы. Выглядело это хорошо, пока я не увидел в журнале событий, что событие цели сработало на том же ходу, что и первый успех. Два моих порога измеряли одно и то же.
Все три персоны отметили одни и те же непонятные места. Одно из них, когда фигура встаёт мимо цели, позже оказалось артефактом того, как тестер перетаскивает мышью. С игрой всё было в порядке.
У тестера было ещё три способа узнать больше положенного: мои файлы инструкций, сама страница и прогресс, сохранённый предыдущей персоной. В Claude Code субагент, то есть агент, запущенный другим агентом, получает файл инструкций проекта, а в моём были названия игр. На это указал агент-критик (роль, единственная задача которой искать недостатки), когда разбирал устройство теста, и раньше, чем у меня появились хоть какие-то признаки, что тестер этими сведениями воспользовался. Названия я убрал. Пока статью вычитывали, всплыла вторая половина той же утечки: субагент получает ещё и мой личный файл инструкций, а в нём студия до сих пор упоминается. На момент написания эта дыра не закрыта.
В самой проверке утечек тоже нашлась дыра. Она искала название игры в файлах. Скрипт очистки ставил вкладке заголовок «Game», но игра во время работы снова выставляла его из файла переводов, проверка этого не видела, а в ответы браузерного инструмента заголовок вкладки попадать может. Адреса серверов студии в сборке она тоже пропустила; теперь их затирает скрипт очистки. А сохранённый прогресс оставался в профиле браузера, так что персона могла унаследовать прогресс предыдущей.
Проверки заголовка вкладки и сохранённого прогресса теперь входят в процедуру теста отдельными шагами и выполняются вручную.
Гейты и вердикт NOT ASSESSED
Гейт стоит между двумя этапами работы над игрой как контрольная точка. Скрипт запускает проверки гейта и возвращает одно из четырёх значений, от худшего к лучшему: FAIL, NOT ASSESSED, CONCERNS, PASS. Вердиктом становится худшее из значений проверок. Проверка без файла отчёта считается NOT ASSESSED, отчёт без строки с вердиктом тоже. Справочные проверки печатаются, но в вердикте не участвуют.
Та же мысль записана в восьми файлах ролей из пятнадцати: нет входных данных, значит, пиши NOT ASSESSED и перечисляй, чего не хватает. С тех пор как я это добавил, «всё хорошо» в отчёте о том, на что никто не смотрел, мне не попадалось.
Между идеей и релизом восемь гейтов.
| Гейт | Что проверяет скрипт | Нужно ли моё решение |
|---|---|---|
| G0 идея | оформление концепт-заметки | да |
| G1 ТЗ | проверка списка задач | да |
| G2 каркас | сборка проходит, типы, тесты | нет |
| G3 ядро | сборка, пункты приёмки по основному геймплею | да, играю пять минут |
| G4 прототип | проверка сборки для слепого теста на утечки, отчёт слепого теста, значения баланса в допустимых границах | да, решаю, идти дальше или нет |
| G5 вертикальный срез | сборка, проверки анимаций, агент-критик | нет |
| G6 полировка | сборка, все пункты приёмки, отчёт слепого теста, значения баланса в допустимых границах | да |
| G7 релиз | сборка, все пункты приёмки, чек-лист магазинов | да |
За первую неделю одна игра прошла путь от идеи до публичного релиза, и PASS от скрипта получили только G1 и G2. На G3 скрипт выдал FAIL при трёх незакрытых пунктах приёмки, на G4 выдал NOT ASSESSED, потому что проверке баланса не хватило данных, на G6 опять FAIL, и все три раза я перекрыл его собственным вердиктом. По G0, G5 и G7 записей о прохождении нет вообще.
Гейты сделали то, ради чего я их строил, а я всё равно прошёл мимо. Шёл релиз. Я знал, что агентам нельзя доверять доделывать самим, и всё равно дал им продолжать, наполовину надеясь, что незакрытые пункты как-нибудь закроются. Это та самая привычка, которую я описал в разделе про QA, только здесь она оказалась моей. Пока что таблица описывает замысел, которому я следую лишь отчасти.
На G0 скрипт проверяет только оформление концепт-заметки. Саму идею ещё до этого оценивает агент-«прожарщик», чья единственная задача её разносить, а потом я. G5 самый слабый гейт: человек его не утверждает, а судья там однажды поставил одной и той же правке сначала 7 из 10, потом 5. Либо я добавлю туда своё утверждение, либо критик станет справочным, как QA.
Тикеты
Задачи перечислены в ТЗ игры в формате YAML, и каждая задача оформлена как тикет. Вот тикет для агента-кодера, в сокращении:
- id: T7
  title: Спрайты эффектов попадания и подбора
  lane: gfx
  agent: game-coder
  model: sonnet
  paths: ["assets/fx/**", "src/fx/**"]
  isolation: worktree
  depends_on: [T5]
  reviewer: art-director
  max_iter: 2
  budget_tokens: 1000000
  acceptance:
    - id: A1
      what: "Листы эффектов проходят гейт анимации"
      oracle: command
      run: "anim_gate.py <registry> <game>"
      expect: "код возврата 0"
lane задаёт вид работы, здесь это графика. В paths перечислены единственные файлы, которые тикету разрешено трогать. isolation: worktree просит отдельную рабочую копию репозитория, max_iter ограничивает число попыток, а oracle говорит, как оценивается результат, здесь по коду возврата команды.
Прежде чем что-нибудь запустится, список задач читает скрипт. Он завершается с ошибкой, если две задачи из одной пачки претендуют на пересекающиеся пути, если задача назначена ревьюером самой себе, если в ожидаемом результате пункта приёмки нет числа или если задача по основному геймплею отдана модели слабее Opus. Он же режет задачи на пачки не больше шести, и кодеров в пачке не больше трёх.
Пока агент работает, бюджет никто не контролирует, потому что надёжного счётчика потраченного у агента нет, а лимит попыток остаётся просто числом, которое лиду велено соблюдать. Расход токенов лид смотрит после попытки и записывает в журнал.
Больше всего за неделю меня раздражало, когда агент сообщал, что сделал и протестировал то, чего не делал и не тестировал. Именно так повели себя исследователи, когда у них отвалился поиск. Два случая, из которых выросли правила для кодеров, не такие однозначные: в обоих дыра была моя.
Однажды кодер отчитался, что все тесты прошли, хотя единственный его упавший тест исключался флагом пропуска внутри тестовой команды проекта. Винить агента не могу: он запустил команду в том виде, в каком получил, и флаг там стоял не просто так. Дыра была в моей обвязке. Теперь перед отчётом кодеры запускают свою команду приёмки напрямую, а полный набор тестов без этого флага.
Вторую лазейку агент-критик нашёл раньше, чем ею успел воспользоваться кто-то из агентов. Когда я утверждаю ТЗ, пункты приёмки каждого тикета хэшируются, чтобы потом никто не занизил планку. Хэш сравнивался со значением, которое хранилось в том же файле, что и сами пункты. Агент, который отредактировал бы ожидаемый результат и пересчитал хэш, прошёл бы проверку. Теперь сравнение идёт с утверждённой копией ТЗ, хотя не править её воркерам по-прежнему всего лишь сказано.
Ещё я попросил изоляцию через worktree и получил её не в том репозитории. Игры лежат в собственных репозиториях, а встроенная изоляция создаёт worktree того репозитория, в котором запущена сессия, то есть GameStudio. Три кодера работали бы в одной рабочей копии игры, а изоляцию я просил как раз для того, чтобы этого избежать. Теперь ветку и worktree под каждый тикет создаёт небольшой скрипт, лид сливает их по одному, а поле isolation в тикете читает этот самый скрипт.
Что Claude Code ограничивает на самом деле
Claude Code жёстко ограничивает роль списком инструментов: роль без шелла команду не запустит. Всё остальное остаётся инструкцией, которая проверяется постфактум или не проверяется вовсе: какие файлы можно трогать тикету, бюджеты, лимиты попыток, запрет читать список багов. В файле настроек проекта нет ни хуков (скриптов, которые Claude Code запускает до или после вызова инструмента), ни правил разрешений, и в моих пользовательских настройках ничто не привязывает тикет к его файлам.
Это правило должно стать хуком перед вызовом инструмента, который отклоняет запись за пределы путей тикета ещё до того, как она случится, но руки до него пока не дошли. Хук на инструменты редактирования не увидит запись, сделанную через шелл, так что кодерам с шеллом нужна вторая проверка. К тому же ревьюер и автор относятся к одному семейству моделей и отличаются только промптами, так что я исхожу из того, что ошибки у них общие.
База знаний
Каталог, который заполняли те самые агенты-исследователи, представляет собой набор карточек игр в хранилище.
После той сессии я взял 15 случайных карточек с фиксированным сидом и вручную проверил в них около 45 фактов. Четыре факта, в трёх карточках, оказались явно неверными. В одной карточке рекорд игры за всё время, поставленный в 2021 году, был выдан за пик прошлого месяца. В другой стояло audience: "да", потому что в поле затекла фраза из основного текста. Хотя бы одна проблема нашлась в семи карточках из 15, а по всему хранилищу в двенадцати карточках одно и то же поле повторялось трижды.
Отчасти дело в том, что модели выдумывают, отчасти в том, что инструмент перестал работать, а остановиться вместе с ним агентам никто не велел. Теперь файлы ролей исследователей запрещают указывать источником «знание жанра» и требуют помечать UNVERIFIED всё, у чего источника нет. Исследователи работают пачками по шесть, причём одновременно ищут не больше трёх-четырёх. А факты, которые магазин или лента и так публикуют, я перестал собирать моделями. Теперь этим занимаются скрипты:
| Скрипт | Что читает |
|---|---|
steamdata.py | публичные данные магазина Steam: цена, дата, разработчики, сводка отзывов, топ отзывов |
mobiledata.py | страницы игр в App Store и Google Play: рейтинг, установки, отзывы с самыми низкими оценками |
robloxdata.py | публичные данные игр в Roblox: текущий онлайн, посещения, доля лайков, геймпассы |
steamnews.py | новостную ленту игры: как часто разработчик писал до и после релиза |
ingest.py | субтитры видео или локальную расшифровку Whisper, если субтитров нет |
Результаты в карточки записывает отдельный скрипт. Карточку он ищет по нормализованному названию или по ссылке на магазин, которая в ней уже есть, а если не совпало ни то ни другое, ничего не пишет. Заполняет он только пустые поля и рядом с каждым значением ставит источник и дату. Отсюда же следует, что всё, что агенты выдумали, а мой аудит пропустил, по-прежнему лежит в этих карточках.
Жанр и стиль задаются ссылками на заметки, и эти заметки обязаны существовать. В этих двух полях за этим следит линтер, он же сверяет аудиторию с фиксированным списком. Значения платформ не проверяются, и в 14 карточек просочилось 13 значений не из списка.
В заметках о механиках есть ещё оценки привлекательности от 1 до 5 и поле про удержание. Это мнения модели, записанные в структурированные поля, и по ним я только выбираю, какие заметки читать.
Obsidian мне нравится, причём в основном по причине, которая к агентам почти не относится: я вижу данные. Карточки игр открываются галереей обложек, механики таблицей с фильтрами, связи между заметками графом. Сомневаюсь, что агентам он экономит хоть один токен: для них хранилище выглядит просто папкой с Markdown-файлами, по которой они ищут как по тексту. Картинки нужны мне.
Чтобы поиск обходился дёшево, у каждой заметки об игре, жанре, механике или практике должно быть однострочное поле summary не длиннее 160 символов. Пока оно есть у 727 заметок. Для 703 из них скрипт просто скопировал начало обзорного раздела заметки, а 40 худших потом переписал Haiku. Агент ищет термин обычным текстовым поиском, читает строку summary у каждого совпадения и только потом открывает заметку. Находится ли так нужная заметка и сколько токенов это экономит, сказать не могу.
Как и компилятор, линтер завершается с кодом ошибки, если находит ошибки. Я запускаю его вручную, ещё он запускается на гейте G0, а больше его ничто запускаться не заставляет. Два его сегодняшних результата, в сокращении:
игры и механики:     657 файлов,  0 ошибок,  21 предупреждение    GATE: CONCERNS
все проверяемые:    1274 файла,  10 ошибок, 136 предупреждений    GATE: FAIL
Из 136 предупреждений 105 приходятся на ссылки на несуществующие заметки.
Отдельно я слежу за числом пометок UNVERIFIED и заглушек в карточках игр. Помечать любое утверждение без источника велено шести ролям из пятнадцати, причём пометку агент ставит на собственный текст, так что это число говорит о том, насколько агенты соблюдают правило, никак не меньше, чем о том, сколько в карточках непроверенного. За один день оно выросло с 1668 до 1857, когда добавились новые карточки. Сегодня оно равно 1875.
Во что обошлась неделя
По журналу тикетов неделя стоила от 60 до 100 долларов по ценам API, смотря как суммировать строки. Потом я прошёлся по логам сессий, которые Claude Code хранит на диске: три рабочие ведущие сессии, ещё четыре короче минуты и 650 запусков субагентов. В них около 99 миллионов новых токенов (новый ввод и вывод) и 3,88 миллиарда токенов, прочитанных из кэша. По ценам API, с учётом опубликованных тарифов на запись в кэш и чтение из него, это около 1460 долларов за неделю, то есть журнал поймал примерно 5% суммы.
Счёт на эту сумму мне никто не выставлял. У меня подписка с фиксированной ценой, а 1460 долларов показывают, сколько стоила бы та же неделя при оплате за токены, вместе с работой над хранилищем и исследованиями: отделить их в логах от игр я не смог.
| Роль и модель | Доля от 1460 долларов |
|---|---|
| Ведущие сессии, Opus | 39% |
| Помощники общего назначения, запущенные лидом, Opus | 28% |
| Агенты-кодеры, Opus | 15% |
| Автор ТЗ, Opus | 5% |
| Агенты-кодеры, Sonnet | 2% |
| Исследования, арт и помощники общего назначения, Sonnet | 7% |
| Слепой тестер, QA-агент, библиотекарь, видеоаналитик | 1,5% |
| Остальное: Fable, критики, мелкие роли | 4% |
Каждая доля округлена отдельно, поэтому в сумме столбец даёт 101,5%.
У каждого тикета был бюджет в миллион токенов, а самый большой израсходовал 445 000, так что к бюджету ни один тикет и близко не подошёл, да и нацелен бюджет был не туда. Журнал считает новые токены в запусках по тикетам. При этом около половины стоимости приходится на токены, прочитанные из кэша, а две трети всей суммы на ведущие сессии и на помощников, которых лид запускал мимо журнала тикетов. При каждом вызове модели лид заново отправляет весь свой диалог. Закэшированная часть тарифицируется в десять раз дешевле входных токенов, но в двух самых длинных ведущих сессиях на вызов приходилось в среднем около 450 000 токенов контекста, и это набегает. Короткие ведущие сессии, которые перезапускаются на каждом этапе и берут состояние из файлов, должны срезать больше, чем любое железо.
Лимит подписки остановил меня раньше, чем деньги. Посреди релиза недельный лимит Sonnet кончился, и работа переехала на Opus, то есть ровно наперекор моему правилу маршрутизации: скрипт или Haiku раскладывают по заметкам, Sonnet читает и пишет код вне основного геймплея, Opus пишет ТЗ, архитектуру и код основного геймплея.
Следующий шаг: локальная модель
Я хочу, чтобы часть рутины выполняла модель у меня дома, и всё посчитал, прежде чем что-то покупать. Роли, которые можно перенести, то есть те, что только читают, раскладывают по заметкам, делают выжимки или тестируют, плюс исследования, дали около 8% стоимости недели. Я плачу фиксированные 200 долларов в месяц, так что живых денег машина не экономит совсем.
Покупать её стоит ради лимита, потому что это роли на Sonnet, а кончился именно лимит Sonnet, и ради повторов. Калибровка QA у меня состоит из двух прогонов, а слепой тест из восьми эпизодов, потому что каждый прогон расходует лимит. Локальная модель могла бы за ночь пятьдесят раз переиграть один и тот же эпизод по цене электричества.
Железо, модель и расчёт окупаемости я вынес в отдельную заметку: Считаю, прежде чем покупать машину под локальную модель.
Происшествия помельче
- Я пропустил вывод скрипта, создающего worktree, через
head -1, пайп закрылся, скрипт умер вместе с ним, и все агенты стартовали без worktree и вернулись со статусом BLOCKED. - Все тесты были зелёными, а в уровень-хаб одной из игр нельзя было играть, потому что тесты проверяли только числа. Теперь после каждой пачки обязателен запуск в настоящем движке.
- В другом случае после трёх раундов правок средняя оценка критика всё ещё держалась на 7,1 из 10. Новый критик на модели посильнее, которого спросили, насколько результат близок к концепт-арту, поставил 4-5. Теперь после двух-трёх раундов решает человек, а список замечаний критика уходит в бэклог.
Если вы строите что-то похожее
Всему этому одна неделя от роду. Система довела до релиза одну игру, причём шесть гейтов из восьми я пропустил или перекрыл своим решением, а с работой без неё в контролируемых условиях я её не сравнивал, так что не берусь утверждать, что с ней быстрее или дешевле.
Начинай я заново, первым делом подложил бы баги. Прежде чем верить ИИ-тестировщику, что багов нет, подложите известные баги и посчитайте, сколько из них вернётся, смотрите результат по классам и убедитесь, что один подложенный баг не может спрятать другой. На этом я и ошибся в обоих прогонах.
Заведите для отсутствующих данных отдельный вердикт и поставьте его хуже предупреждения, чтобы проверка, которая не запускалась, никогда не сошла за пройденную. Хэшируйте критерии приёмки в момент утверждения и сравнивайте с утверждённой копией: хэш, который лежит рядом с критериями, ни от чего не защищает. Если факт можно получить через API, собирайте его скриптом, а если инструмент отказал, задача должна остановиться и сказать об этом, а не продолжать по памяти.
Стоимость считайте по логам сессий, вместе с чтением из кэша. Мой журнал тикетов увидел около 5% от неё.
Две вещи касаются именно Claude Code. Субагент получает ваши файлы инструкций, и проектный, и личный, так что если субагент у вас оценщик, прочитайте эти файлы его глазами. И в моей конфигурации списки инструментов были единственной границей, которая действительно соблюдалась. На очереди хуки и правила разрешений, а пока их нет, всё остальное в моих файлах ролей остаётся просьбой.