Я підкинув у гру дванадцять багів, а мій ШІ-тестувальник знайшов чотири
Останній рік я у вільний час роблю невеликі ігри, а останні пів року роблю їх разом із ШІ-агентами, що пишуть код. Код агенти пишуть швидко, так само швидко повідомляють, що все працює, і до листопада я вже не розумів, яким із їхніх зелених галочок можна вірити.
Тому я витратив тиждень на те, щоб обкласти агентів перевірками, а потім повернувся й перевірив самі перевірки.
Заголовок якраз про цю другу частину. Я підкинув дванадцять багів у збірку (це копія гри, в яку можна грати) і віддав її своєму QA-агентові, який шукає в іграх баги. Він знайшов чотири. Я виправив його інструкції, переніс баг, що обірвав перший прогін, і запустив агента ще раз. Він знову знайшов чотири.
Того ж тижня вилізли ще дві речі. Мого «сліпого» тестувальника, який не має нічого знати про гру, в яку грає, я запускав усередині проєкту, де у файлі інструкцій були назви ігор. А за одну сесію я запустив двадцять-тридцять дослідницьких агентів, щоб наповнити каталог карток ігор, по одній нотатці на гру. Десь посередині в них перестав працювати інструмент вебпошуку, а вони все одно писали картки далі. Джерелом написаного дехто з них указав «знання жанру».
Те, що вийшло, я називаю GameStudio. Система працює на Claude Code з моделями Claude Haiku 5.5, Sonnet 5.5 та Opus 5.5, і є ще одна модель, Fable 5.2, для одного-єдиного завдання з економіки гри. Ця стаття про систему, тож ігри в ній згадуються лише як те, на чому я її випробовував. Цифри взято з мого репозиторію та з двох журналів, які в ньому ведуться: файлу уроків і журналів тікетів. Обидва описано нижче.
Що лежить у репозиторії
Сховище з 1 361 Markdown-нотатки в Obsidian містить те, що я зібрав про ринок із відкритих джерел. Нотатки розкладено за типами: ігри, механіки, жанри, джерела, рішення й уроки. Поруч лежить близько сорока скриптів, які тягнуть дані та запускають перевірки. Майже жоден із них не викликає мовну модель. Винятки: обгортки для генерації зображень, 3D і звуку, локальна транскрипція через Whisper і один скрипт, що запускає агента за розкладом.
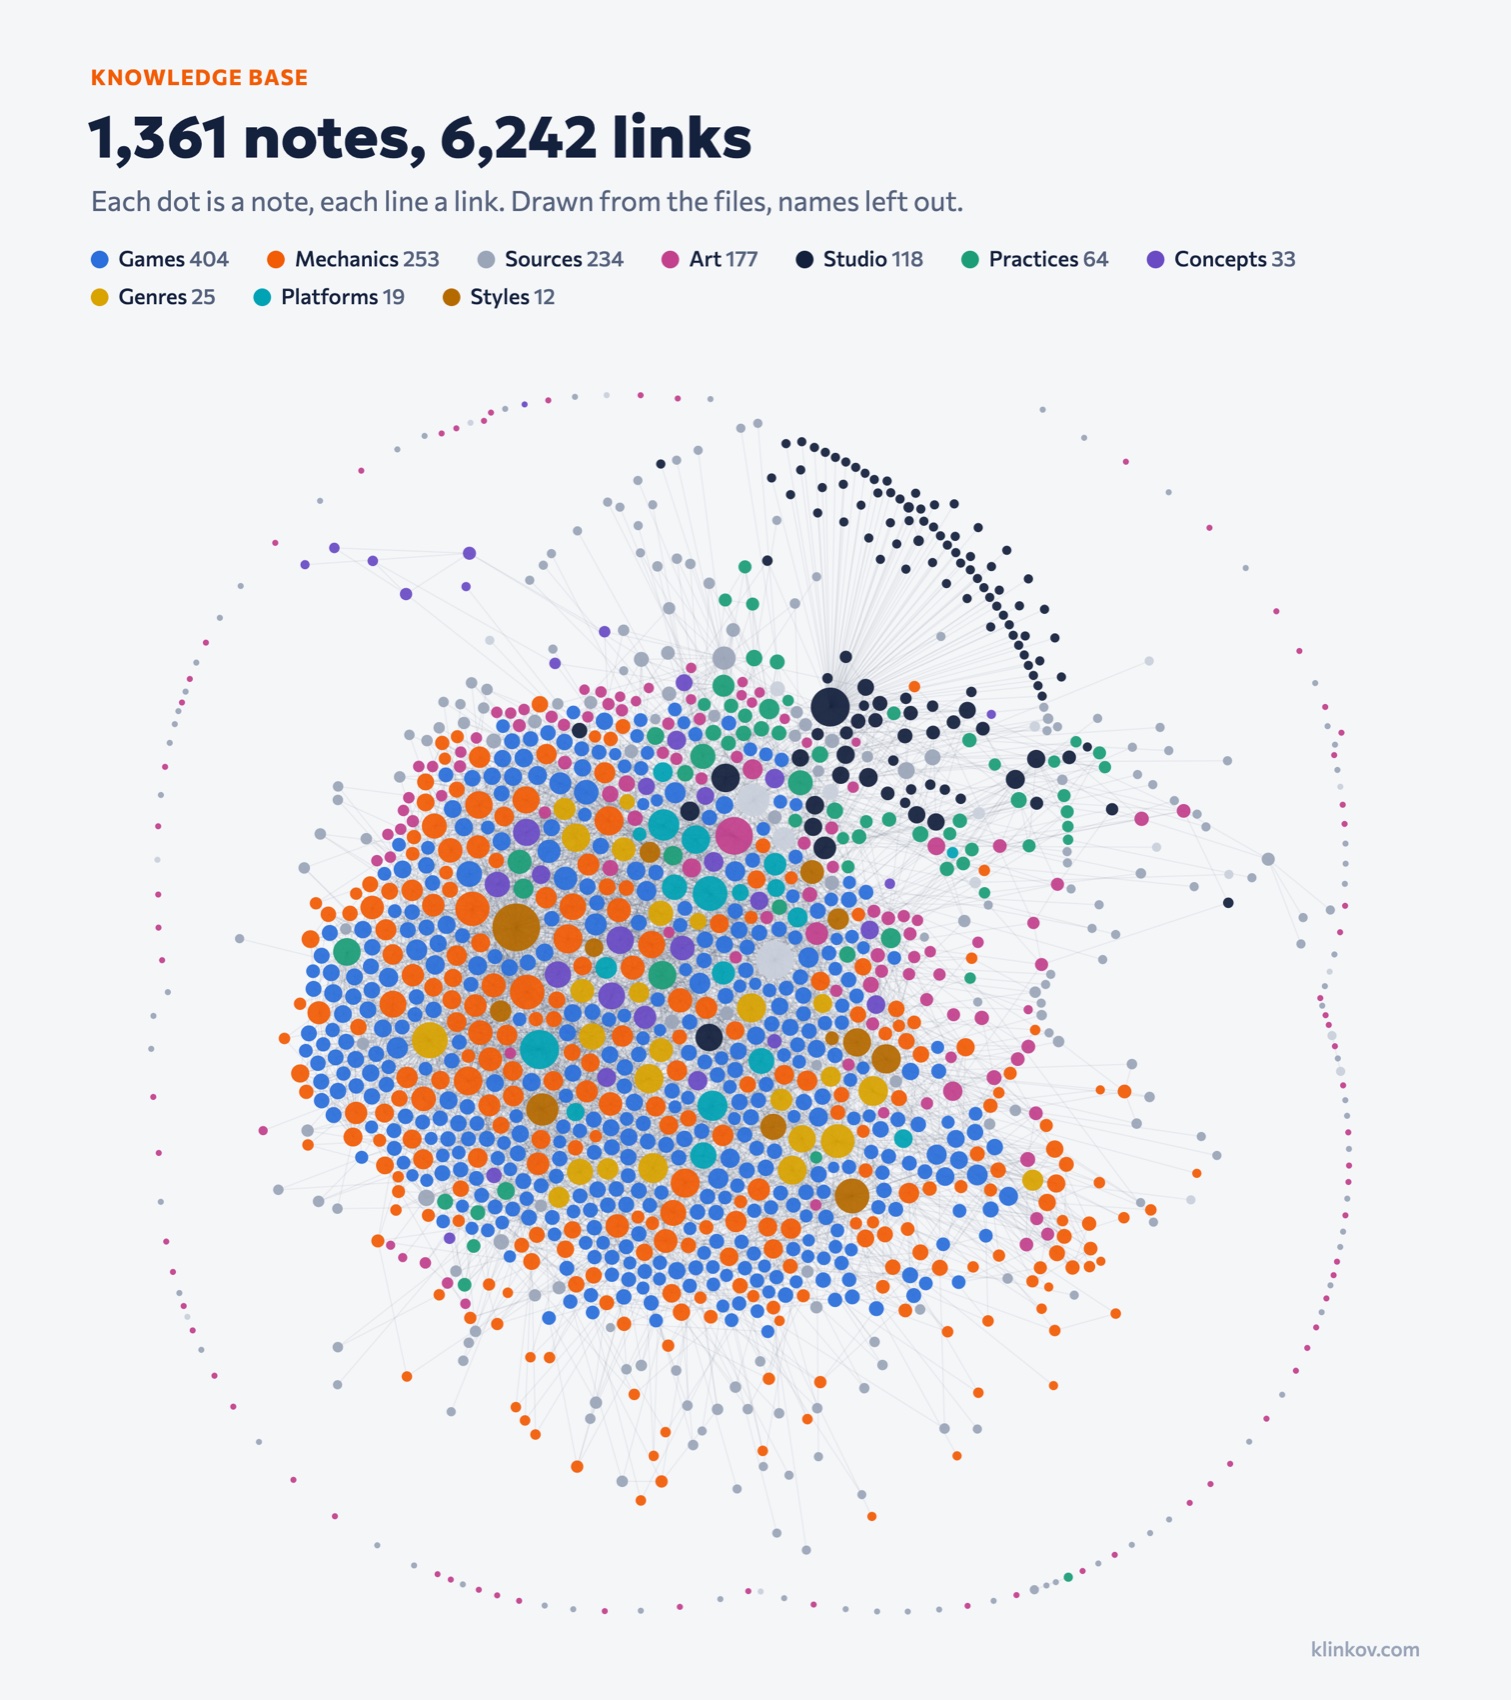
Третя частина складається із самих агентів: п’ятнадцять ролей, де роль описує роботу одного типу агента, як посадова інструкція, і шістнадцять навичок, тобто інструкцій для одного типу завдань, які можна використовувати повторно. Усе це звичайні Markdown-файли, які завантажує Claude Code.
З п’ятнадцяти ролей одночасно працює лише кілька. Є одна провідна сесія, тобто головний агент, який роздає роботу, далі до трьох виконавців, що пишуть код, і один рецензент, а робота, де треба тільки читати, розходиться пакетами щонайбільше по шість агентів. Навіть трьох кодерів виявилося забагато для одного спільного файлу з тестами: його редагували всі, і на кожному злитті в ньому виникали конфлікти, тож тепер його чіпає тільки провідна сесія.
Стан зберігається у файлах, бо виконавець ніколи не бачить розмови провідної сесії й отримує лише тікет. Виконавець-кодер відповідає у фіксованому форматі, щонайбільше 300 слів: статус done, partial або BLOCKED, файли, які він змінив, і код завершення кожної команди приймання. Кожна спроба потрапляє рядком у журнал тікетів гри, а про все, що пішло не так, з’являється датований запис у файлі уроків. Типовий запис у перекладі: «Сесія запустила близько 16 важких перевірок паралельно, Mac завис (навантаження 160)». Із цього випадку виросло правило: не більше чотирьох-шести важких процесів на сесію.
QA-агент
QA-агент грає у збірку в headless-браузері. ТЗ він знає. Доступу до shell у нього немає, тож запускати команди він не може. Зате є інструмент Write, бо звіт треба кудись записати, тож перезаписати якийсь файл йому не дають лише інструкції.
Він раз у раз повертався без багів, і це було б доброю новиною, якби я мав хоч якесь уявлення, чи здатен він знайти бодай один. Тому я взяв копію гри і вписав у неї дванадцять багів, які вмикаються тестовим прапорцем: кнопку «Продовжити» в меню паузи, яка нічого не робила, лічильник із неправильним максимумом, рожеву смугу через увесь екран і ще дев’ять. На цій копії я й запустив агента. Після першого прогону я змінив його інструкції (продовжувати після падіння, перевіряти два розміри вікна, на кожному екрані проходити чекліст класів багів), переніс підкинуте падіння, яке його зупинило, на пізніший момент гри й запустив агента вдруге.
| Клас бага | Підкинуто | Знайдено в прогоні 1 | Знайдено в прогоні 2 |
|---|---|---|---|
| Падіння або виняток | 2 | 2 | 1 |
| Неправильне число на екрані | 2 | 1 | 1 |
| Візуальний артефакт | 1 | 1 | 0 |
| Глухий кут | 1 | 0 | 1 |
| Елемент керування, який нічого не робить | 1 | 0 | 1 |
| Текст виходить за межі | 2 | 0 | 0 |
| Прогалина в туторіалі | 1 | 0 | 0 |
| Витік пам’яті | 1 | 0 | 0 |
| Неперекладений текстовий ключ | 1 | 0 | 0 |
| Разом | 12 | 4 | 4 |
У першому прогоні він подав п’ять звітів про баги, у другому чотири, і всі, крім одного, відповідали підкинутому багові. Той один зайвий я так і не перевірив, тому частоти хибних спрацювань назвати не можу. Звіти, які він подає, здебільшого правильні, і їх мало.
Частково недобір пояснюється тим, як я сам побудував тест. У першому прогоні підкинуте падіння завершило сесію достроково, коли шість із дванадцяти багів були ще попереду. У другому підкинутий глухий кут сховав два баги, а ще три були на екрані, до якого агент так і не дійшов. І все це лише два прогони однієї моделі на одній грі.
Я цілив у повноту 50% (повнота показує, яку частку справжніх багів агент знаходить), а двічі отримав 33%, причому на тесті, що кожного разу ховав від агента п’ять чи шість багів із дванадцяти. Я б не вважав 33% його повнотою. З тих багів, до яких він міг дістатися, він знайшов чотири з шести в першому прогоні і чотири з семи в другому, але це дві малі вибірки, і на них я теж не спирався б. Витік пам’яті входив у підрахунок, хоча побачити його агентові нема чим. Я показав лише те, що доказів високої повноти в мене немає і що одного падіння досить, аби сховати все, що за ним.
Друга четвірка мене не здивувала. Я ніколи не вірив, що агентові можна лишити всю роботу, і тут уперше біля цього переконання з’явилася цифра, хай і слабка. Агент звітує «готово» тим самим упевненим тоном незалежно від того, зроблено роботу чи ні. Я користуюся цими інструментами щодня, і їх усе одно треба перевіряти. Як видно з розділу про гейти, я й сам перевіряю не завжди.
Таблиця мені потрібна заради розбивки за класами. Агент ловив падіння та винятки, неправильні числа, глухий кут і елемент керування, який нічого не робить, а візуальний артефакт спіймав в одному прогоні з двох. Текст, що виходить за межі, він пропустив обидва рази: першого разу тому, що перевіряв лише один розмір вікна, другого тому, що дії закінчилися раніше, ніж він дійшов до вузького вікна. Витік пам’яті він не спіймає взагалі, бо не має інструмента, який вимірює пам’ять. Тут потрібен скрипт, і я його ще не написав.
Після цього я понизив QA до дорадчого статусу. Його результат друкується у звіті кожного гейта (це контрольна точка між етапами розробки, про них далі), а вердикт його не враховує.
Перед кожним справжнім QA-прогоном скрипт тепер вмикає три баги зі списку підкинутих багів гри, і якщо агент знаходить менше двох, його звіт анулюється. Якби агент знаходив кожен із трьох незалежно з імовірністю одна третина, а іншої оцінки в мене немає, це правило анулювало б приблизно три звіти з чотирьох. На практиці результат залежить від того, які саме три обрано, бо чотири з дев’яти класів не знайдено в жодному прогоні. До того ж правило повторює мою власну помилку щоразу, коли один із трьох виявляється падінням, що ховає решту. Тож успішне проходження відсіює лише лінивий прогін. Під час першого справжнього застосування агент не знайшов жодного з трьох, і звіт було викинуто; новий агент, якому підказали, як керувати грою, знайшов два.
Список багів зберігається в теці гри, яку QA-агент може читати, і зупиняє його лише рядок в інструкціях.
Сліпий тест і його витоки
Сліпий тест відповідає на питання, чи зрозуміє перший екран людина, яка нічого не знає наперед. Для мене це швидка перша перевірка онбордингу, тобто того, як гра знайомить із собою нового гравця, і не більше, бо його вердикти я жодного разу не порівнював зі справжніми гравцями.
У списку інструментів сліпого тестувальника дев’ять дій у браузері, і це все. Ось заголовок файлу його ролі, з назв прибрано префікс сервера інструментів:
name: blind-tester
model: sonnet
tools: browser_take_screenshot, browser_mouse_click_xy, browser_mouse_move_xy,
  browser_mouse_drag_xy, browser_mouse_down, browser_mouse_up,
  browser_mouse_wheel, browser_press_key, browser_type
Він не може читати файли, запускати код, відкривати консоль браузера чи переходити на іншу сторінку. Провідна сесія відкриває збірку, а тестувальник отримує вкладку. Перед тим скрипт зачищає збірку: прибирає source maps, файли з вихідним кодом, HTML-коментарі та метатеги, а заголовок сторінки замінює на «Game». У брифі є персона (тип гравця, якого треба зіграти), номер епізоду (епізодом я називаю одну коротку ігрову сесію щонайбільше з 15 дій) і власні нотатки тестувальника з попередніх епізодів. Назви гри, жанру чи мети там немає.
Одна з персон описана як семирічна дитина, яка не вміє читати, а грає її модель, що читає кожне слово на скриншоті. Як це обійти, я не придумав.
Наприкінці епізоду тестувальник повертає один JSON-запис. Ось шаблон із файлу ролі, скорочено:
{
  "episode": 1,
  "persona": "семирічна дитина, яка не вміє читати",
  "game_guess": "що це, на мою думку, за гра, однією фразою",
  "goal_understood": true,
  "goal_when": 3,
  "first_success": "що спрацювало першим і на якій дії",
  "dead_ends": ["дія 5: що я спробував, чого очікував, що сталося"],
  "would_quit": null,
  "unclear": ["чого я не зрозумів на екрані"],
  "hint_used": "none"
}
Тут у goal_when записано номер дії, на якій мета стала зрозумілою, а у would_quit дію, на якій такий гравець здався б, або null. У JSON тестувальник сам розповідає про себе, і цій частині я довіряю найменше. Таймінги беруться з подій, які сама гра надсилає в тестовий стенд: мету побачено, перший успіх, рівень пройдено. Це секунди реального часу від завантаження сторінки, і в них входить час, поки модель думає, тож десять секунд для моделі не дорівнюють десяти секундам для дитини. Чесніше було б рахувати в діях, і номер дії в записі вже є.
На іграшковій грі один епізод із восьми викликів інструментів витратив 18 120 свіжих токенів Sonnet (свіжими я називаю ті, що не прочитані з кешу). Перший справжній прогін, три персони й вісім епізодів загалом, витратив близько 330 000, бо справжні епізоди довші за іграшковий.
Пороги проходження такі: мета зрозуміла щонайбільше за 10 секунд, перший успіх щонайбільше за 60 секунд і не більше однієї підказки за п’ять хвилин. Справжній прогін пройшов усі: у кожної персони обидві події наставали приблизно через дев’ять секунд після завантаження сторінки. Усе виглядало добре, доки я не побачив у журналі подій, що подія мети спрацювала на тому самому ході, що й перший успіх. Два мої пороги міряли одне й те саме.
Усі три персони повідомили про ті самі незрозумілі місця. Одне з них, фігура, що лягала повз ціль, згодом виявилося артефактом того, як тестувальник перетягує мишею. З грою все було гаразд.
Тестувальник мав ще й три способи дізнатися більше, ніж треба: мої файли інструкцій, сама сторінка і прогрес, збережений попередньою персоною. У Claude Code підагент, тобто агент, запущений іншим агентом, отримує файл інструкцій проєкту, а в моєму були назви ігор. Агент-критик, роль якого зводиться до пошуку вад, вказав на це, коли перевіряв налаштування, ще до того, як у мене з’явилася бодай якась ознака, що тестувальник цією інформацією скористався. Назви я прибрав. Поки цю статтю рецензували, спливла друга половина того самого витоку: підагент отримує ще й мій особистий файл інструкцій, де досі згадано студію. Цей витік на момент написання ще не закрито.
Перевірка на витоки мала власну дірку. Вона шукала у файлах назву гри, і хоча скрипт зачистки виставив заголовок вкладки «Game», гра під час роботи виставляла його знову з файлу перекладів, тож перевірка цього не бачила, а відповіді браузерного інструмента можуть містити заголовок вкладки. Так само вона пропустила адреси серверів студії у збірці; тепер скрипт зачистки їх затирає. А збережений прогрес лишався у профілі браузера, тож одна персона могла успадкувати прогрес попередньої.
Перевірки заголовка вкладки та збереженого прогресу тепер входять до процедури тестування як окремі кроки, і виконуються вони вручну.
Гейти і вердикт NOT ASSESSED
Гейтом я називаю контрольну точку між двома етапами гри. Скрипт запускає перевірки гейта і повертає одне з чотирьох значень, від найгіршого до найкращого: FAIL, NOT ASSESSED, CONCERNS і PASS. Вердиктом стає найгірше значення серед перевірок. Перевірка, для якої немає файлу звіту, зараховується як NOT ASSESSED, так само як і звіт без рядка з вердиктом. Дорадчі перевірки друкуються, але у вердикт не входять.
Ту саму ідею записано у восьми з п’ятнадцяти файлів ролей: якщо не маєш вхідних даних, пиши NOT ASSESSED і перелічи, чого бракує. Відколи я це додав, я не бачив «усе добре» у звіті про те, на що ніхто не дивився.
Між ідеєю та релізом стоїть вісім гейтів.
| Гейт | Що перевіряє скрипт | Чи потрібне моє рішення |
|---|---|---|
| G0 ідея | формат нотатки з концептом | так |
| G1 ТЗ | перевірка списку завдань | так |
| G2 каркас | збірка успішна, типи, тести | ні |
| G3 ядро | збірка, пункти приймання для ядра геймплею | так, я граю п’ять хвилин |
| G4 прототип | перевірка на витоки у збірці для сліпого тесту, звіт сліпого тесту, значення балансу в допустимих межах | так, іти далі чи ні |
| G5 вертикальний зріз | збірка, перевірки анімації, агент-критик | ні |
| G6 полірування | збірка, усі пункти приймання, звіт сліпого тесту, значення балансу в допустимих межах | так |
| G7 реліз | збірка, усі пункти приймання, чекліст магазину | так |
За перший тиждень одна гра пройшла шлях від ідеї до публічного релізу, і лише G1 та G2 отримали від скрипту PASS. На G3 скрипт видав FAIL із трьома відкритими пунктами приймання, на G4 видав NOT ASSESSED, бо перевірка балансу не мала даних, на G6 знову FAIL, і всі три рази я перекрив його власним вердиктом. Для G0, G5 і G7 записів про гейт немає взагалі.
Гейти зробили те, заради чого я їх будував, а я все одно їх обійшов. Я був посеред релізу. Я знав, що агентів не можна лишати доробляти самих, і дозволив їм працювати далі, наполовину сподіваючись, що відкриті пункти якось закриються самі. Це та сама звичка, яку я описав у розділі про QA, тільки тут вона була моя. Поки що ця таблиця лишається задумом, якого я дотримуюся лише частково.
На G0 скрипт перевіряє тільки те, чи правильно оформлено нотатку з концептом. Саму ідею ще раніше оцінює агент для «прожарки», якому доручено тільки нападати на неї, а потім я. Найслабшим із гейтів я вважаю G5: людина там нічого не погоджує, а суддя якось оцінив ту саму зміну на 7 із 10, а потім на 5. Або я додам власне погодження, або критик стане дорадчим, як QA.
Тікети
ТЗ гри перелічує її завдання в YAML, і кожне завдання стає тікетом. Ось один для агента-кодера, скорочено:
- id: T7
  title: Спрайти ефектів удару та підбирання
  lane: gfx
  agent: game-coder
  model: sonnet
  paths: ["assets/fx/**", "src/fx/**"]
  isolation: worktree
  depends_on: [T5]
  reviewer: art-director
  max_iter: 2
  budget_tokens: 1000000
  acceptance:
    - id: A1
      what: "Аркуші спрайтів ефектів проходять гейт анімації"
      oracle: command
      run: "anim_gate.py <registry> <game>"
      expect: "код завершення 0"
lane задає вид роботи, тут це графіка. paths перелічує файли, які тікет має право чіпати, і більше жодних. isolation: worktree просить окрему робочу копію репозиторію, max_iter обмежує кількість дозволених спроб, а oracle каже, як оцінюється результат, тут за кодом завершення команди.
Перш ніж щось запуститься, скрипт читає список завдань. Він падає з помилкою, якщо два завдання з одного пакета претендують на шляхи до файлів, що перетинаються, якщо завдання рецензує саме себе, якщо в очікуванні пункту приймання немає жодного числа або якщо завдання з ядра геймплею призначено моделі, слабшій за Opus. Він же ділить завдання на пакети щонайбільше по шість, і кодерів у пакеті щонайбільше троє.
Бюджет не контролюється, поки агент працює, бо агент не має надійного лічильника витраченого, а обмеження ітерацій лишається тільки числом, якого провідній сесії сказано дотримуватися. Провідна сесія читає витрату токенів після спроби й записує її в журнал.
Найбільше мене за весь тиждень дратувало, коли агент казав, що щось зробив і протестував, хоча не робив цього. Дослідницькі агенти вчинили саме так, коли в них відвалився інструмент пошуку. Два випадки, що стали правилами для кодерів, не такі однозначні, бо в обох дірка була моя.
Якось агент-кодер відзвітував, що всі тести пройшли, тоді як його єдиний тест, що падав, було виключено прапорцем пропуску всередині тестової команди проєкту. Звинувачувати агента я не можу: він запустив команду так, як йому її дали, а прапорець стояв там не просто так. Дірка була в моєму тестовому стенді. Тепер перед звітом кодери запускають власну команду приймання напряму, а також повний набір тестів без прапорця.
Другу лазівку знайшов агент-критик, раніше ніж нею скористався якийсь агент. Пункти приймання кожного тікета хешуються, коли я затверджую ТЗ, щоб ніхто потім не занизив планку. Хеш порівнювався зі значенням, що зберігалося в тому самому файлі, що й пункти. Агент, який відредагував би очікування і перерахував хеш, пройшов би перевірку. Тепер порівняння бере затверджену копію ТЗ, а виконавцям, як і раніше, лише сказано її не редагувати.
Ще я попросив ізоляцію через worktree й отримав її не для того репозиторію. Ігри лежать у власних репозиторіях, а вбудована ізоляція створює worktree того репозиторію, в якому працює сесія, тобто GameStudio. Троє кодерів ділили б одну робочу копію гри, а саме від цього ізоляція й мала вберегти. Тепер невеликий скрипт створює гілку та worktree на кожен тікет, провідна сесія зливає їх по одному, а поле isolation у тікеті читає саме цей скрипт.
Що Claude Code обмежує по-справжньому
Claude Code жорстко дотримується списків інструментів, тож роль без доступу до shell не може запустити команду. Усе інше лишається інструкцією, яку перевіряють постфактум або не перевіряють зовсім: які файли може чіпати тікет, бюджети, обмеження ітерацій, заборона читати список багів. У файлі налаштувань проєкту немає ні хуків (це скрипти, які Claude Code запускає до або після виклику інструмента), ні правил дозволів, і в моїх користувацьких налаштуваннях ніщо не тримає тікет у межах його файлів.
Це правило має бути хуком перед викликом інструмента, який відхиляє запис поза шляхами тікета ще до того, як він станеться, і руки до нього в мене ще не дійшли. Хук на інструментах редагування не побачить запису, зробленого через shell, тому кодерам із доступом до shell потрібна друга перевірка. До того ж рецензент і автор походять з однієї родини моделей і різняться лише промптами, тож я виходжу з того, що помилки в них спільні.
База знань
Каталог, який наповнювали ті дослідницькі агенти, складається з карток ігор у сховищі.
Після тієї сесії я навмання витягнув 15 карток із фіксованим seed і вручну перевірив у них близько 45 фактів. Чотири факти були явно хибні, у трьох картках. Одна картка подавала рекорд гри за весь час, поставлений у 2021 році, як її пік за попередній місяць. В іншій стояло audience: "yes", бо в поле потрапило речення з основного тексту. Сім із 15 карток мали принаймні одну проблему того чи іншого роду, а в усьому сховищі знайшлося дванадцять карток, де одне й те саме поле повторювалося тричі.
Частково це вигадки моделей, а частково наслідок того, що інструмент перестав працювати і ніщо не сказало агентам зупинитися разом із ним. Тепер файли дослідницьких ролей забороняють «знання жанру» як джерело й вимагають позначати все, що не має джерела, як UNVERIFIED. Дослідницькі агенти працюють пакетами по шість, і одночасно шукають щонайбільше три чи чотири. І я перестав збирати моделями факти, які магазин чи стрічка й так публікують. Тепер це роблять скрипти:
| Скрипт | Що він читає |
|---|---|
steamdata.py | публічні дані магазину Steam: ціна, дата, розробники, зведення відгуків, найпопулярніші відгуки |
mobiledata.py | сторінки в App Store і Google Play: рейтинг, кількість встановлень, відгуки з найнижчими оцінками |
robloxdata.py | публічні дані ігор Roblox: гравці онлайн, відвідування, співвідношення голосів, геймпаси |
steamnews.py | стрічка новин гри: як часто розробник публікував дописи до і після релізу |
ingest.py | субтитри відео або локальна транскрипція Whisper, коли субтитрів немає |
Окремий скрипт записує результати в картки. Картку він шукає за нормалізованою назвою або за посиланням на магазин, яке в ній уже є, і нічого не пише, якщо не збігається ні те, ні те. Він заповнює лише порожні поля й біля кожного значення ставить джерело та дату. Звідси випливає й інше: усе вигадане агентами й пропущене моїм аудитом досі лежить у тих картках.
Жанр і стиль записано як посилання на нотатки, які мусять існувати. Для цих двох полів це перевіряє лінтер, він же стежить за фіксованим списком аудиторій. Значення платформ не перевіряються, і в 14 карток пролізло 13 значень не зі списку.
Нотатки про механіки мають ще оцінки привабливості від 1 до 5 і поле утримання. Це думки моделі, записані в структуровані поля, і я користуюся ними лише для того, щоб вибрати, які нотатки читати.
Obsidian мене влаштовує, здебільшого з причини, яка мало стосується агентів: я бачу дані. Картки ігор відкриваються галереєю обкладинок, механіки таблицею з фільтрами, а зв’язки між нотатками графом. Сумніваюся, що агентам це заощаджує бодай один токен, бо для них сховище нічим не відрізняється від теки Markdown-файлів, у якій вони шукають по тексту. Картинки потрібні мені.
Щоб пошук був дешевим, нотатки про ігри, жанри, механіки та практики повинні мати summary на один рядок, щонайбільше 160 символів. Поки що його мають 727 нотаток. Для 703 із них скрипт просто скопіював початок оглядового розділу нотатки, а 40 найгірших із них переписав Haiku. Агент шукає термін як звичайний текст, читає рядок summary кожного збігу і лише після цього відкриває нотатку. Чи знаходиться так потрібна нотатка і скільки токенів це заощаджує, сказати не можу.
Як і компілятор, лінтер завершується з кодом помилки, коли знаходить помилки. Я запускаю його вручну, ще він запускається на гейті G0, і більше ніщо не змушує його запускатися. Два його сьогоднішні результати, у перекладі та стисло:
ігри та механіки:        657 файлів,  0 помилок,  21 попередження   GATE: CONCERNS
усі перевірені нотатки: 1274 файли,  10 помилок, 136 попереджень    GATE: FAIL
Зі 136 попереджень 105 припадає на посилання на нотатки, яких не існує.
Серед чисел, за якими я стежу, є кількість позначок UNVERIFIED і позначок заготовки в картках ігор. Шістьом із п’ятнадцяти ролей сказано позначати будь-яке твердження без джерела, а позначку агент ставить на власний текст, тож це число говорить мені про те, як добре агенти дотримуються правила, щонайменше стільки ж, скільки про обсяг неперевіреного. За один день воно зросло з 1 668 до 1 857, бо надійшли нові картки. Сьогодні воно становить 1 875.
Скільки коштував тиждень
Мій журнал тікетів за тиждень дає в сумі десь від $60 до $100 за офіційними цінами API, залежно від того, як підсумовувати його рядки. Потім я пройшовся по журналах сесій, які Claude Code зберігає на диску: три робочі провідні сесії, чотири, що тривали менше хвилини, і 650 запусків підагентів. У них близько 99 мільйонів свіжих токенів (нові вхідні та вихідні) і 3,88 мільярда токенів, прочитаних із кешу. За офіційними цінами, якщо рахувати запис у кеш і читання з кешу за опублікованими тарифами, це близько $1 460 за тиждень, тобто журнал охопив приблизно 5% цієї суми.
Це не рахунок до сплати. Я плачу фіксовану передплату, а $1 460 показує, скільки коштував би той самий тиждень з оплатою за токени, разом зі сховищем і дослідницькою роботою, бо в журналах я не зміг відділити їх від ігор.
| Роль і модель | Частка від $1 460 |
|---|---|
| Провідні сесії, Opus | 39% |
| Помічники загального призначення, яких запускала провідна сесія, Opus | 28% |
| Агенти-кодери, Opus | 15% |
| Автор ТЗ, Opus | 5% |
| Агенти-кодери, Sonnet | 2% |
| Дослідження, арт і загальні помічники, Sonnet | 7% |
| Сліпий тестувальник, QA-агент, бібліотекар, відеоаналітик | 1,5% |
| Усе інше: Fable, критики, дрібні ролі | 4% |
Кожну частку округлено окремо, тому стовпець у сумі дає 101,5%.
Кожен тікет мав бюджет у мільйон токенів, а найбільший витратив 445 000, тож жоден тікет і близько не підійшов до свого бюджету, та й націлено бюджет було не туди. Журнал рахує свіжі токени в запусках за тікетами. Близько половини вартості становлять токени, прочитані з кешу, а дві третини загальної суми сидять у провідних сесіях і в помічниках, яких провідна сесія запускала поза журналом тікетів. З кожним викликом моделі провідна сесія надсилає всю свою розмову заново. Кешована частина коштує одну десяту від ціни вхідних токенів, але у двох найдовших моїх провідних сесіях у середньому було близько 450 000 токенів контексту на виклик, і це набігає. Коротші провідні сесії, які перезапускаються на кожному етапі й беруть стан із файлів, мають зрізати більше, ніж будь-яке залізо.
Квота передплати зупинила мене раніше, ніж вартість. Посеред релізу закінчився тижневий ліміт Sonnet, і робота перейшла на Opus, якраз навпаки, ніж каже моє правило маршрутизації: скрипт або Haiku для впорядкування, Sonnet для читання та коду поза ядром, Opus для ТЗ, архітектури й коду ядра геймплею.
Наступний крок: локальна модель
Я хочу, щоб частина рутинної роботи йшла на моделі в мене вдома, і порахував усе, перш ніж щось купувати. Ролі, які можна перенести, тобто ті, що лише читають, впорядковують, стисло переказують або тестують, плюс дослідження, склали близько 8% вартості тижня. Я плачу фіксовані $200 на місяць, тож у грошах машина нічого не заощаджує.
Купувати її варто заради квоти, бо це ролі на Sonnet, а закінчився саме ліміт Sonnet, і заради повторів. Моє калібрування QA складається з двох прогонів, а сліпий тест із восьми епізодів, бо кожен прогін з’їдає квоту. Локальна модель могла б за ніч переграти той самий епізод п’ятдесят разів за ціною електрики.
Залізо, модель і арифметику окупності я виніс в окрему нотатку, Рахую, перш ніж купувати машину під локальну модель.
Дрібніші інциденти
- Я спрямував вивід скрипту worktree через пайп у
head -1, пайп закрився, скрипт помер разом із ним, і кожен агент стартував без worktree й повернувся зі статусом BLOCKED. - Усі тести були зелені, а в хаб-рівень однієї гри не можна було грати, бо тести перевіряли лише числа. Тепер запуск у справжньому рушії після кожного пакета обов’язковий.
- В окремому випадку після трьох раундів виправлень середня оцінка критика все ще була 7,1 із 10. Новий критик на сильнішій моделі, якого спитали, наскільки результат близький до концепт-арту, поставив від 4 до 5. Тепер після двох чи трьох раундів вирішує людина, а список критика йде в беклог.
Якщо ви будуєте щось схоже
Усьому цьому один тиждень. Система довела до релізу одну гру, причому шість із восьми її гейтів було пропущено або перекрито, і я не порівнював у контрольованих умовах роботу з нею та без неї, тому не стверджую, що з нею швидше чи дешевше.
Якби я починав знову, то почав би з підкидання багів. Перш ніж вірити словам ШІ-тестувальника «багів немає», підкиньте відомі баги й порахуйте, скільки повернеться, читайте результат за класами багів і подбайте, щоб один підкинутий баг не міг сховати інший. Саме в цьому я помилився в обох прогонах.
Дайте відсутнім доказам окремий вердикт і поставте його гірше за попередження, щоб перевірка, яка не запускалася, ніколи не виглядала як пройдена. Хешуйте критерії приймання, коли їх затверджуєте, і порівнюйте із затвердженою копією; хеш, що зберігається поруч із критеріями, нічого не захищає. Якщо факт можна взяти з API, збирайте його скриптом, а коли інструмент відмовляє, завдання має зупинитися й сказати про це, а не працювати далі з пам’яті.
Рахуйте вартість за журналами сесій, разом із читанням із кешу. Мій журнал тікетів побачив близько 5% від неї.
Дві речі стосуються саме Claude Code. Підагент отримує ваші файли інструкцій, і проєктний, і особистий, тож якщо підагент виступає оцінювачем, прочитайте ці файли так, як прочитав би їх він. І в моїй системі списки інструментів були єдиною межею, якої справді не можна було переступити. Хуки та правила дозволів на черзі, а доки їх немає, усе інше в моїх файлах ролей лишається проханням.