Podłożyłem w grze dwanaście bugów, a mój tester AI znalazł cztery
Od roku w wolnym czasie robię małe gry, a od pół roku robię je z agentami AI piszącymi kod. Agenci piszą szybko i równie szybko zapewniają mnie, że wszystko działa, więc w listopadzie nie wiedziałem już, którym z ich zielonych ptaszków wierzyć.
Poświęciłem więc tydzień na obudowanie ich kontrolami, a potem wróciłem i przetestowałem same kontrole.
Tytuł wziął się z tej drugiej części. Podłożyłem dwanaście bugów w buildzie (grywalnej kopii gry) i dałem go agentowi QA, czyli temu, który szuka w grach bugów. Znalazł cztery. Poprawiłem mu instrukcje, przesunąłem ten jeden bug, który urwał pierwszy przebieg, i uruchomiłem agenta ponownie. Znów znalazł cztery.
W tym samym tygodniu wyszły jeszcze dwie rzeczy. „Ślepy” tester, który ma nie wiedzieć nic o grze, w którą gra, był uruchamiany wewnątrz projektu, którego plik z instrukcjami wymieniał gry z nazwy. A w jednej sesji uruchomiłem od dwudziestu do trzydziestu agentów badawczych, żeby wypełnili katalog kart gier, po jednej notatce na grę. W trakcie pracy przestało im działać narzędzie do wyszukiwania w sieci, a oni mimo to pisali karty dalej. Jako źródło część z nich podała „znajomość gatunku”.
To, co z tego wyszło, nazywam GameStudio. Działa na Claude Code z modelami Claude Haiku 5.5, Sonnet 5.5 i Opus 5.5 oraz jeszcze jednym, Fable 5.2, do jednego zadania przy ekonomii gry. Ten artykuł jest o tym systemie, więc gry pojawiają się w nim tylko jako materiał, na którym go testowałem. Liczby pochodzą z mojego repozytorium i z dwóch prowadzonych w nim logów: pliku z wnioskami i dzienników ticketów. Oba opisuję niżej.
Co jest w repozytorium
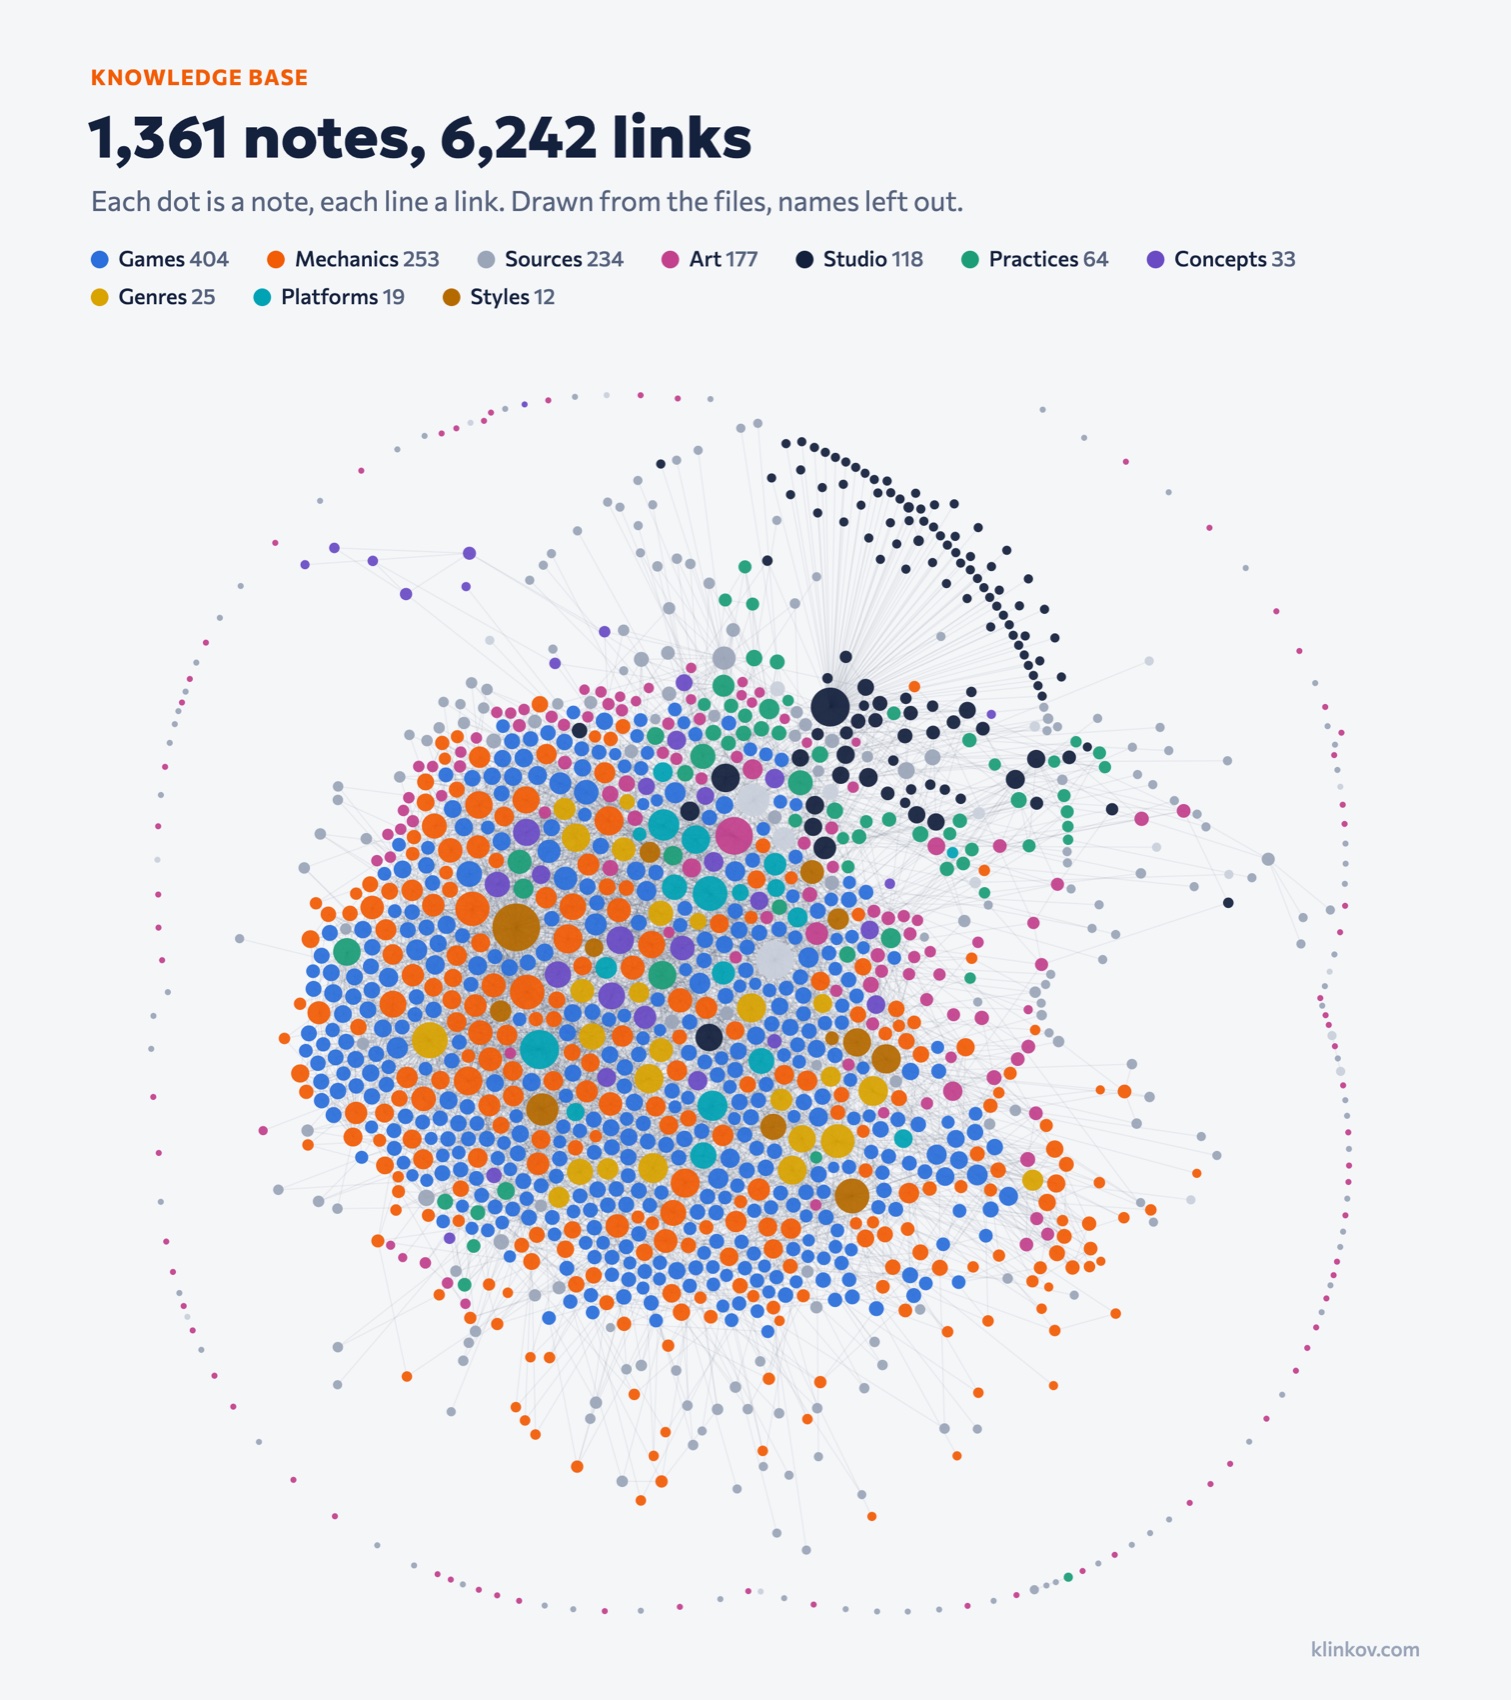
Vault z 1361 notatkami Markdown w Obsidianie zawiera to, co zebrałem o rynku z publicznych źródeł, z podziałem na gry, mechaniki, gatunki, źródła, decyzje i wnioski. Obok leży około czterdziestu skryptów, które pobierają dane i uruchamiają kontrole. Prawie żaden z nich nie wywołuje modelu językowego. Wyjątki to wrappery do generowania obrazów, modeli 3D i dźwięku, lokalna transkrypcja Whisperem oraz jeden skrypt, który uruchamia agenta według harmonogramu.
Trzecia część to sami agenci: piętnaście ról, gdzie rola to opis stanowiska dla jednego rodzaju agenta, i szesnaście skilli, czyli instrukcji wielokrotnego użytku do jednego rodzaju zadań. Wszystko to zwykłe pliki Markdown, które ładuje Claude Code.
Z tych piętnastu ról naraz działa tylko kilka. Jest jedna sesja główna, czyli agent nadrzędny, który rozdziela pracę, do tego najwyżej trzech wykonawców piszących kod i jeden recenzent, a zadania tylko do odczytu idą partiami po najwyżej sześciu agentów. Nawet trzech koderów okazało się za dużo na jeden wspólny plik testów, który edytowali wszyscy i który dawał konflikt przy każdym merge'u, więc teraz rusza go tylko sesja główna.
Stan trzymam w plikach, bo wykonawca nigdy nie widzi rozmowy sesji głównej i dostaje wyłącznie ticket. Wykonawca piszący kod odpowiada w ustalonym formacie, najwyżej 300 słów: status done, partial albo BLOCKED, pliki, które ruszył, i kod wyjścia każdego polecenia akceptacyjnego. Każda próba trafia jako wiersz do dziennika ticketów danej gry, a wszystko, co pójdzie źle, dostaje wpis z datą w pliku z wnioskami. Typowy wpis, w tłumaczeniu: „Sesja uruchomiła równolegle około 16 ciężkich kontroli, Mac się zawiesił (load 160)”. Wynikła z tego reguła: limit od czterech do sześciu ciężkich procesów na sesję.
Agent QA
Agent QA ogrywa build w przeglądarce w trybie headless. Zna specyfikację. Nie ma powłoki, więc nie może uruchamiać poleceń. Ma za to narzędzie Write, bo raport musi gdzieś trafić, a to oznacza, że przed nadpisaniem jakiegoś pliku powstrzymują go wyłącznie instrukcje.
Ciągle wracał bez bugów, co byłoby dobrą wiadomością, gdybym miał jakiekolwiek pojęcie, czy w ogóle potrafi jakiś znaleźć. Wziąłem więc kopię gry i wpisałem w nią dwanaście bugów ukrytych za flagą testową: przycisk „Kontynuuj” w menu pauzy, który nic nie robił, licznik z błędnym maksimum, różowy pas przez cały ekran i dziewięć innych. Na tej kopii uruchomiłem agenta. Po pierwszym przebiegu zmieniłem mu instrukcje (kontynuuj po crashu, sprawdź dwa rozmiary okna, na każdym ekranie przejdź listę kontrolną klas bugów), przesunąłem podłożony crash, który go zatrzymał, w późniejsze miejsce gry i uruchomiłem agenta drugi raz.
| Klasa bugu | Podłożone | Znalezione w przebiegu 1 | Znalezione w przebiegu 2 |
|---|---|---|---|
| Crash lub wyjątek | 2 | 2 | 1 |
| Błędna liczba na ekranie | 2 | 1 | 1 |
| Artefakt wizualny | 1 | 1 | 0 |
| Ślepy zaułek | 1 | 0 | 1 |
| Kontrolka, która nic nie robi | 1 | 0 | 1 |
| Tekst niemieszczący się w polu | 2 | 0 | 0 |
| Luka w samouczku | 1 | 0 | 0 |
| Wyciek pamięci | 1 | 0 | 0 |
| Nieprzetłumaczony klucz tekstu | 1 | 0 | 0 |
| Razem | 12 | 4 | 4 |
W pierwszym przebiegu złożył pięć zgłoszeń, w drugim cztery, i wszystkie poza jednym odpowiadały podłożonym bugom. Tego jednego nadmiarowego nigdy nie sprawdziłem, więc odsetka fałszywych alarmów nie podam. Zgłoszenia, które składa, są w większości trafne, tylko jest ich mało.
Część braków to wina tego, jak zaprojektowałem test. W pierwszym przebiegu podłożony crash zakończył sesję przedwcześnie, kiedy sześć z dwunastu bugów było jeszcze za nim. W drugim podłożony ślepy zaułek zasłonił dwa bugi, a trzy inne były na ekranie, do którego agent nigdy nie dotarł. A wszystko to dwa przebiegi jednego modelu na jednej grze.
Dla czułości, czyli odsetka prawdziwych bugów, które agent znajduje, założyłem cel 50%, a dwa razy dostałem 33% w teście, który za każdym razem chował przed agentem pięć albo sześć z dwunastu bugów. Tych 33% nie brałbym za jego czułość. Z bugów, do których mógł dotrzeć, znalazł cztery z sześciu w pierwszym przebiegu i cztery z siedmiu w drugim, a to dwie małe próbki, na których też bym się nie opierał. Wyciek pamięci był wliczony, chociaż agent nie ma jak go zobaczyć. Pokazałem tylko tyle, że nie mam dowodów na jego wysoką czułość i że jeden crash wystarczy, żeby schować wszystko, co jest za nim.
Druga czwórka mnie nie zaskoczyła. Nigdy nie wierzyłem, że agentowi można zostawić całą robotę, a teraz pierwszy raz miałem przy tym przekonaniu liczbę, choćby słabą. Agent melduje „zrobione” tym samym pewnym tonem niezależnie od tego, czy praca jest zrobiona, czy nie. Używam tych narzędzi codziennie i nadal trzeba je sprawdzać. Jak widać w części o bramkach, sam nie zawsze to robię.
Z tabeli przydaje mi się przede wszystkim podział na klasy. Agent złapał crashe i wyjątki, błędne liczby, ślepy zaułek i kontrolkę, która nic nie robi, a artefakt wizualny złapał w jednym przebiegu z dwóch. Tekst niemieszczący się w polu przeoczył dwa razy: za pierwszym razem dlatego, że sprawdzał jeden rozmiar okna, za drugim dlatego, że skończyły mu się akcje, zanim doszedł do wąskiego okna. Wycieku pamięci nie złapie wcale, bo nie ma narzędzia, które mierzy pamięć. Do tego potrzebny jest skrypt, a jeszcze go nie napisałem.
Po tym wszystkim zdegradowałem QA do roli doradczej. Jego wynik jest wypisywany w raporcie każdej bramki (punktu kontrolnego między etapami prac, opisanego niżej), ale do werdyktu się nie liczy.
Przed każdym prawdziwym przebiegiem QA skrypt włącza teraz trzy bugi z listy podłożonych bugów danej gry, a jeśli agent znajdzie mniej niż dwa, jego raport jest unieważniany. Gdyby agent znajdował każdy z tych trzech niezależnie z prawdopodobieństwem jednej trzeciej, bo to jedyny wskaźnik, jaki mam, reguła unieważniałaby mniej więcej trzy raporty na cztery. W praktyce wynik zależy od tego, które trzy zostaną wybrane, bo czterech z dziewięciu klas agent nie znalazł w żadnym przebiegu, a reguła powtarza mój własny błąd za każdym razem, kiedy jednym z tych trzech jest crash chowający pozostałe. Zaliczenie wyklucza więc tylko leniwy przebieg. Przy pierwszym prawdziwym użyciu agent nie znalazł żadnego z trzech i raport poszedł do kosza. Nowy agent, który dostał podpowiedź, jak sterować grą, znalazł dwa.
Lista bugów leży w folderze gry, który agent QA może czytać, i powstrzymuje go tylko jedna linijka w instrukcjach.
Ślepy test i jego przecieki
Ślepy test ma odpowiedzieć na pytanie, czy ktoś, kto nic o grze nie wie, zrozumie pierwszy ekran. Traktuję go jako szybki pierwszy test onboardingu, czyli tego, jak gra przedstawia się nowemu graczowi, i nic ponad to, bo nigdy nie porównałem jego werdyktów z prawdziwymi graczami.
Lista narzędzi ślepego testera to dziewięć akcji w przeglądarce i nic więcej. Oto nagłówek pliku jego roli, z nazw usunąłem prefiks serwera narzędzi:
name: blind-tester
model: sonnet
tools: browser_take_screenshot, browser_mouse_click_xy, browser_mouse_move_xy,
  browser_mouse_drag_xy, browser_mouse_down, browser_mouse_up,
  browser_mouse_wheel, browser_press_key, browser_type
Nie może czytać plików, uruchamiać kodu, otworzyć konsoli przeglądarki ani przejść na inną stronę. Build otwiera sesja główna, a tester dostaje kartę. Wcześniej skrypt czyści ten build: usuwa source mapy, pliki źródłowe, komentarze HTML i metatagi, a tytuł strony zmienia na „Game”. Brief podaje personę (rodzaj gracza, którego trzeba naśladować), numer epizodu (epizod to jedna krótka sesja gry, najwyżej 15 akcji) oraz własne notatki testera z wcześniejszych epizodów. Nie podaje nazwy gry, gatunku ani celu.
Jedna z person to siedmiolatek, który nie umie czytać, a gra go model, który czyta każde słowo na zrzucie ekranu. Nie znalazłem na to sposobu.
Na koniec epizodu tester zwraca jeden rekord JSON. Oto szablon z pliku roli, skrócony:
{
  "episode": 1,
  "persona": "siedmiolatek, który nie umie czytać",
  "game_guess": "czym według mnie jest ta gra, w kilku słowach",
  "goal_understood": true,
  "goal_when": 3,
  "first_success": "co zadziałało jako pierwsze i przy której akcji",
  "dead_ends": ["akcja 5: czego spróbowałem, czego się spodziewałem, co się stało"],
  "would_quit": null,
  "unclear": ["czego nie mogłem zrozumieć na ekranie"],
  "hint_used": "none"
}
Tutaj goal_when to numer akcji, przy której cel stał się jasny, a would_quit to akcja, przy której taki gracz by zrezygnował, albo null. JSON jest relacją samego testera i tej części ufam najmniej. Czasy pochodzą ze zdarzeń, które sama gra wysyła do harnessu testowego: cel zauważony, pierwszy sukces, poziom ukończony. To sekundy czasu rzeczywistego liczone od załadowania strony, razem z czasem namysłu modelu, więc dziesięć sekund dla modelu to nie dziesięć sekund dla dziecka. Uczciwiej byłoby liczyć w akcjach, a numer akcji i tak jest już w rekordzie.
Na zabawkowej grze jeden epizod złożony z ośmiu wywołań narzędzi zużył 18 120 świeżych tokenów Sonneta (świeżych, czyli nieodczytanych z cache'u). Pierwszy prawdziwy przebieg, trzy persony i łącznie osiem epizodów, zużył około 330 000, bo prawdziwe epizody są dłuższe niż ten zabawkowy.
Progi zaliczenia to cel zrozumiany w ciągu 10 sekund, pierwszy sukces w ciągu 60 sekund i najwyżej jedna podpowiedź na pięć minut. Prawdziwy przebieg zaliczył wszystkie. Oba zdarzenia przychodziły u każdej persony mniej więcej dziewięć sekund po załadowaniu strony, co wyglądało dobrze, dopóki nie zobaczyłem w logu zdarzeń, że zdarzenie celu odpalało się przy tym samym ruchu co pierwszy sukces. Dwa z moich progów mierzyły jedną rzecz.
Wszystkie trzy persony zgłosiły te same niejasności. Jedna z nich, element lądujący obok celu, okazała się później artefaktem tego, jak tester przeciąga myszą. Z grą wszystko było w porządku.
Tester miał też trzy sposoby, żeby dowiedzieć się więcej, niż powinien: moje pliki z instrukcjami, samą stronę oraz postęp zapisany przez poprzednią personę. W Claude Code subagent, czyli agent uruchomiony przez innego agenta, dostaje plik z instrukcjami projektu, a mój wymieniał gry z nazwy. Agent krytyk, czyli rola, której jedynym zadaniem jest szukanie wad, wytknął to podczas przeglądu konfiguracji, zanim miałem jakikolwiek sygnał, że któryś tester z tej informacji skorzystał. Nazwy usunąłem. W trakcie recenzji tego artykułu wyszła druga połowa tego samego przecieku: subagent dostaje też mój osobisty plik z instrukcjami, a w nim studio nadal jest wspomniane. Kiedy to piszę, ta sprawa jest nadal otwarta.
Kontrola przecieków miała własną dziurę. Przeszukiwała pliki pod kątem nazwy gry i chociaż skrypt czyszczący ustawiał tytuł karty na „Game”, gra ustawiała go ponownie w czasie działania, z pliku tłumaczeń. Kontrola nigdy więc tego nie widziała, a odpowiedzi narzędzia przeglądarki mogą zawierać tytuł karty. Przeoczyła też adresy serwerów studia w buildzie. Skrypt czyszczący teraz je usuwa. Do tego zapisany postęp zostawał w profilu przeglądarki, więc jedna persona mogła odziedziczyć postęp poprzedniej.
Tytuł karty i zapisany postęp sprawdzam teraz ręcznie, jako kroki procedury testowej.
Bramki i werdykt o nazwie NOT ASSESSED
Bramka to punkt kontrolny między dwoma etapami prac nad grą. Skrypt uruchamia kontrole bramki i zwraca jedną z czterech wartości, od najgorszej do najlepszej: FAIL, NOT ASSESSED, CONCERNS i PASS. Werdyktem zostaje najgorsza wartość spośród kontroli. Kontrola, której pliku z raportem brakuje, liczy się jako NOT ASSESSED, tak samo jak raport bez linijki z werdyktem. Kontrole doradcze są wypisywane, ale nie wchodzą do werdyktu.
Ta sama zasada jest zapisana w ośmiu z piętnastu plików ról: jeśli nie masz danych wejściowych, napisz NOT ASSESSED i wymień, czego brakuje. Odkąd ją dodałem, nie widziałem „wszystko w porządku” w raporcie o czymś, czego nikt nie obejrzał.
Między pomysłem a wydaniem jest osiem bramek.
| Bramka | Co sprawdza skrypt | Wymaga mojej decyzji |
|---|---|---|
| G0 pomysł | format notatki z konceptem | tak |
| G1 specyfikacja | kontrola listy zadań | tak |
| G2 szkielet | build przechodzi, typy, testy | nie |
| G3 rdzeń | build, kryteria akceptacji dla rdzenia rozgrywki | tak, gram przez pięć minut |
| G4 prototyp | kontrola przecieków w buildzie do ślepego testu, raport ze ślepego testu, wartości balansu w zadanych granicach | tak, decyzja go/no-go |
| G5 vertical slice | build, kontrole animacji, agent krytyk | nie |
| G6 szlify | build, wszystkie kryteria akceptacji, raport ze ślepego testu, wartości balansu w zadanych granicach | tak |
| G7 wydanie | build, wszystkie kryteria akceptacji, checklista sklepu | tak |
W pierwszym tygodniu jedna gra przeszła od pomysłu do publicznego wydania i tylko G1 oraz G2 dostały od skryptu PASS. Na G3 skrypt zwrócił FAIL przy trzech otwartych kryteriach akceptacji, na G4 zwrócił NOT ASSESSED, bo kontrola balansu nie miała danych, na G6 znów FAIL, i we wszystkich trzech przypadkach nadpisałem jego werdykt własnym. G0, G5 i G7 nie mają żadnego zapisu z bramki.
Bramki zrobiły to, do czego je zbudowałem, a ja i tak je ominąłem. Byłem w środku wydania. Wiedziałem, że agentom nie można zostawić dokończenia pracy, a pozwoliłem im jechać dalej, po cichu licząc, że otwarte punkty jakoś same się rozwiążą. To ten sam nawyk, który opisałem w części o QA, tylko tym razem mój. Na razie ta tabela jest projektem, którego trzymam się tylko częściowo.
Na G0 skrypt sprawdza jedynie, czy notatka z konceptem ma poprawny format. Sam pomysł ocenia wcześniej agent od „roastu”, którego jedynym zadaniem jest go zaatakować, a potem ja. G5 to najsłabsza bramka: bez akceptacji człowieka i z sędzią, który kiedyś ocenił tę samą zmianę na 7 z 10, a potem na 5. Albo dodam własną akceptację, albo krytyk dostanie rolę doradczą, tak jak QA.
Tickety
Specyfikacja gry wymienia jej zadania w YAML-u, a każde zadanie to ticket. Oto jeden z nich, dla agenta piszącego kod, skrócony:
- id: T7
  title: Sprite'y efektów trafienia i podniesienia przedmiotu
  lane: gfx
  agent: game-coder
  model: sonnet
  paths: ["assets/fx/**", "src/fx/**"]
  isolation: worktree
  depends_on: [T5]
  reviewer: art-director
  max_iter: 2
  budget_tokens: 1000000
  acceptance:
    - id: A1
      what: "Arkusze efektów przechodzą bramkę animacji"
      oracle: command
      run: "anim_gate.py <registry> <game>"
      expect: "kod wyjścia 0"
lane to rodzaj pracy, tutaj grafika. paths to jedyne pliki, które ticket może ruszyć. isolation: worktree oznacza prośbę o osobną kopię roboczą repozytorium, max_iter to liczba dozwolonych prób, a oracle mówi, jak oceniany jest wynik, tutaj po kodzie wyjścia polecenia.
Zanim cokolwiek ruszy, listę zadań czyta skrypt. Kończy się błędem, jeśli dwa zadania w tej samej partii deklarują nakładające się ścieżki plików, jeśli wykonawca zadania jest zarazem jego recenzentem, jeśli oczekiwanie w kryterium akceptacji nie zawiera żadnej liczby albo jeśli zadanie z rdzenia rozgrywki jest przypisane do modelu słabszego niż Opus. Dzieli też zadania na partie po najwyżej sześć, z najwyżej trzema koderami w partii.
Budżetu nic nie pilnuje w trakcie pracy agenta, bo agent nie ma wiarygodnego licznika tego, ile wydał, a limit iteracji to tylko liczba, której sesja główna ma się trzymać, bo tak ma napisane. Zużycie tokenów sesja główna odczytuje po próbie i wpisuje do dziennika.
Przez cały tydzień najbardziej irytowało mnie to, że agent mówił mi, że coś zrobił i przetestował, kiedy tego nie zrobił. Agenci badawczy zachowali się dokładnie tak, kiedy padło im narzędzie do wyszukiwania. Dwa przypadki, z których powstały reguły dla koderów, są mniej jednoznaczne, bo w obu dziura była moja.
Agent piszący kod zameldował kiedyś, że wszystkie testy przeszły, podczas gdy jedyny test, który u niego nie przechodził, był wyłączony flagą pomijania wewnątrz polecenia testowego projektu. Nie mogę winić agenta, bo uruchomił polecenie tak, jak je dostał, a flaga była tam nie bez powodu. Dziura była w moim harnessie. Koderzy przed złożeniem raportu uruchamiają teraz bezpośrednio własne polecenie akceptacyjne, a do tego pełny zestaw testów bez tej flagi.
Drugą lukę znalazł agent krytyk, zanim jakikolwiek agent ją wykorzystał. Kryteria akceptacji każdego ticketu są haszowane w chwili, gdy zatwierdzam specyfikację, żeby nikt nie mógł później obniżyć poprzeczki. Hasz był porównywany z wartością zapisaną w tym samym pliku co kryteria. Agent, który zmieniłby oczekiwanie i przeliczył hasz, przeszedłby. Porównanie korzysta teraz z zatwierdzonej kopii specyfikacji, a przed jej edycją wykonawców nadal powstrzymuje tylko zakaz w instrukcjach.
Poprosiłem też o izolację przez worktree i dostałem ją dla niewłaściwego repozytorium. Gry są we własnych repozytoriach, a wbudowana izolacja tworzy worktree repozytorium, w którym działa sesja, czyli GameStudio. Trzech koderów dzieliłoby jedną kopię roboczą gry, a właśnie temu izolacja miała zapobiec. Teraz mały skrypt tworzy branch i worktree dla każdego ticketu, sesja główna merguje je po jednym, a pole isolation w tickecie czyta właśnie ten skrypt.
Co wymusza Claude Code
Claude Code wymusza listy narzędzi, więc rola bez narzędzia powłoki nie uruchomi polecenia. Cała reszta to instrukcja, sprawdzana po fakcie albo wcale: które pliki ticket może ruszyć, budżety, limity iteracji, zakaz czytania listy bugów. W pliku ustawień projektu nie ma hooków (skryptów, które Claude Code uruchamia przed wywołaniem narzędzia albo po nim) ani reguł uprawnień, a w moich ustawieniach użytkownika nic nie wymusza zakresu plików ticketu.
Ta reguła powinna być hookiem uruchamianym przed wywołaniem narzędzia, który odrzuca zapis poza ścieżkami ticketu, zanim do niego dojdzie, ale jeszcze się za to nie zabrałem. Hook na narzędziach do edycji nie zobaczy zapisu zrobionego przez powłokę, więc koderzy z powłoką potrzebują drugiej kontroli. Recenzent i autor pochodzą poza tym z tej samej rodziny modeli, tylko z różnymi promptami, więc zakładam, że popełniają te same błędy.
Baza wiedzy
Katalog, który wypełniali tamci agenci badawczy, to zbiór kart gier w vaulcie.
Po tamtej sesji wylosowałem 15 kart ze stałym ziarnem i ręcznie sprawdziłem w nich około 45 faktów. Cztery fakty były ewidentnie błędne, w trzech kartach. Jedna karta podawała rekord wszech czasów gry z 2021 roku jako jej szczyt z poprzedniego miesiąca. Inna miała audience: "yes", bo do pola trafiło zdanie z treści notatki. Siedem z 15 kart miało przynajmniej jeden problem jakiegoś rodzaju, a w całym vaulcie dwanaście kart miało to samo pole powtórzone trzy razy.
Po części to modele, które zmyślają, a po części to, że narzędzie przestało działać i nic nie kazało agentom przestać razem z nim. Pliki ról badawczych zakazują teraz „znajomości gatunku” jako źródła i wymagają, żeby wszystko, co nie ma źródła, było oznaczone jako UNVERIFIED. Agenci badawczy działają w partiach po sześciu, przy czym naraz wyszukuje najwyżej trzech albo czterech. Przestałem też używać modeli do zbierania faktów, które sklep albo feed i tak publikuje. Teraz robią to skrypty:
| Skrypt | Co czyta |
|---|---|
steamdata.py | publiczne dane sklepu Steam: cena, data, deweloperzy, podsumowanie recenzji, najwyżej oceniane recenzje |
mobiledata.py | strony gier w App Store i Google Play: ocena, liczba instalacji, najniżej oceniane recenzje |
robloxdata.py | publiczne dane gier w Roblox: aktualna liczba graczy, odwiedziny, stosunek głosów, game passy |
steamnews.py | feed z nowościami gry: jak często deweloper publikował przed wydaniem i po nim |
ingest.py | napisy do filmu albo lokalną transkrypcję Whisperem, kiedy napisów nie ma |
Osobny skrypt wpisuje wyniki do kart. Dopasowuje kartę po znormalizowanej nazwie albo po linku do sklepu, który już w niej jest, a jeśli nie pasuje ani jedno, ani drugie, nie zapisuje nic. Wypełnia tylko puste pola i przy każdej wartości umieszcza źródło i datę, a to oznacza również, że wszystko, co agenci zmyślili, a mój audyt przeoczył, nadal jest w tych kartach.
Gatunek i styl to linki do notatek, które muszą istnieć. Linter pilnuje tego dla tych dwóch pól, a do tego stałej listy grup odbiorców. Wartości platform nie są sprawdzane i do 14 kart wkradło się 13 wartości spoza listy.
Notatki o mechanikach mają też oceny atrakcyjności od 1 do 5 i pole retencji. To opinie modelu wpisane w ustrukturyzowane pola i używam ich tylko do wybierania, które notatki przeczytać.
Z Obsidiana jestem zadowolony, głównie z powodu, który ma niewiele wspólnego z agentami: widzę dane. Karty gier otwierają się jako galeria okładek, mechaniki jako tabela, którą mogę filtrować, a linki między notatkami jako graf. Wątpię, żeby oszczędzało to agentom choć jeden token, bo dla nich vault to po prostu folder plików Markdown, które przeszukują jako tekst. Obrazki są dla mnie.
Żeby wyszukiwanie było tanie, notatki o grach, gatunkach, mechanikach i praktykach powinny mieć jednolinijkowe summary o długości najwyżej 160 znaków. Jak dotąd ma je 727 notatek. W 703 z nich skrypt po prostu skopiował początek sekcji przeglądowej notatki, a 40 najgorszych spośród nich przepisał Haiku. Agent szuka terminu jako zwykłego tekstu, czyta linijkę z podsumowaniem każdego trafienia i dopiero potem otwiera notatkę. Czy w ten sposób trafia na właściwą notatkę i ile tokenów to oszczędza, tego nie wiem.
Linter, podobnie jak kompilator, kończy pracę z kodem błędu, kiedy znajdzie błędy. Uruchamiam go ręcznie, uruchamia się też na bramce G0 i nic poza tym nie wymusza jego uruchomienia. Jego dwa dzisiejsze wyniki, przetłumaczone i skrócone:
gry i mechaniki:                657 plików,  0 błędów,  21 ostrzeżeń   GATE: CONCERNS
wszystkie sprawdzane notatki:  1274 pliki,  10 błędów, 136 ostrzeżeń   GATE: FAIL
Ze 136 ostrzeżeń 105 to linki do notatek, które nie istnieją.
Jedna z liczb, które obserwuję, to liczba oznaczeń UNVERIFIED i oznaczeń zalążka w kartach gier. Sześć z piętnastu ról ma polecenie oznaczać każde twierdzenie bez źródła, a agent stawia to oznaczenie na własnym tekście, więc ta liczba mówi mi co najmniej tyle samo o tym, jak dobrze agenci trzymają się tej reguły, co o tym, ile rzeczy jest niezweryfikowanych. W ciągu jednego dnia wzrosła z 1668 do 1857, kiedy doszły nowe karty. Dziś wynosi 1875.
Ile kosztował tydzień
Mój dziennik ticketów za ten tydzień sumuje się do kwoty gdzieś między 60 a 100 dolarów według cennika API, zależnie od tego, jak zsumuję jego wiersze. Potem przeszedłem przez logi sesji, które Claude Code trzyma na dysku: trzy robocze sesje główne, cztery, które trwały poniżej minuty, i 650 uruchomień subagentów. Jest w nich około 99 milionów świeżych tokenów (nowe wejście i wyjście) oraz 3,88 miliarda tokenów odczytanych z cache'u. Według cennika, z zapisami do cache'u i odczytami z cache'u po opublikowanych stawkach, daje to około 1460 dolarów za tydzień, czyli dziennik uchwycił mniej więcej 5% tej kwoty.
Żadna z tych kwot nie jest rachunkiem. Płacę stałą opłatę za subskrypcję, a 1460 dolarów to tyle, ile kosztowałby ten sam tydzień, gdybym płacił za tokeny, razem z pracą nad vaultem i pracą badawczą, bo w logach nie umiałem ich oddzielić od gier.
| Rola i model | Udział w 1460 dolarach |
|---|---|
| Sesje główne, Opus | 39% |
| Pomocnicy ogólnego przeznaczenia uruchamiani przez sesję główną, Opus | 28% |
| Agenci piszący kod, Opus | 15% |
| Autor specyfikacji, Opus | 5% |
| Agenci piszący kod, Sonnet | 2% |
| Agenci badawczy, graficzni i pomocnicy ogólni, Sonnet | 7% |
| Ślepy tester, agent QA, bibliotekarz, analityk wideo | 1,5% |
| Cała reszta: Fable, krytycy, małe role | 4% |
Każdy udział jest zaokrąglony osobno, więc kolumna sumuje się do 101,5%.
Każdy ticket miał budżet miliona tokenów, a największy zużył 445 000, więc żaden nawet się do budżetu nie zbliżył, a sam budżet i tak pilnował nie tego, co trzeba. Dziennik liczy świeże tokeny w uruchomieniach objętych ticketami. Mniej więcej połowa kosztu to tokeny odczytywane z cache'u, a dwie trzecie całości siedzi w sesjach głównych i w pomocnikach, których sesja główna uruchomiła poza dziennikiem ticketów. Przy każdym wywołaniu modelu sesja główna wysyła całą swoją rozmowę od nowa. Część z cache'u jest rozliczana po jednej dziesiątej ceny wejścia, ale dwie najdłuższe z moich sesji głównych miały średnio około 450 000 tokenów kontekstu na wywołanie, a to się sumuje. Krótsze sesje główne, restartowane na każdym etapie i zasilane z plików, powinny obciąć więcej, niż obciąłby jakikolwiek sprzęt.
Limit subskrypcji zatrzymał mnie wcześniej niż koszt. W środku wydania skończył się tygodniowy limit Sonneta i praca przeszła na Opusa, dokładnie odwrotnie do mojej reguły routingu, która brzmi: skrypt albo Haiku do porządkowania, Sonnet do czytania i kodu spoza rdzenia, Opus do specyfikacji, architektury i kodu rdzenia rozgrywki.
Następny będzie model lokalny
Chcę, żeby część rutynowej pracy szła na modelu w domu, i przed jakimkolwiek zakupem to przeliczyłem. Role, które mogłyby się przenieść, czyli te, które tylko czytają, porządkują, streszczają albo testują, plus role badawcze, to około 8% kosztu tygodnia. Płacę stałe 200 dolarów miesięcznie, więc w gotówce maszyna nic mi nie oszczędza.
Powodem, żeby ją kupić, jest limit, bo to są role na Sonnecie, a skończył się właśnie limit Sonneta, oraz powtórzenia. Kalibracja QA to u mnie dwa przebiegi, a ślepy test to osiem epizodów, bo każdy przebieg zjada limit. Model lokalny mógłby rozegrać ten sam epizod pięćdziesiąt razy w ciągu nocy za cenę prądu.
Sprzęt, model i wyliczenie zwrotu są w osobnej notatce, Kalkulacja przed zakupem maszyny pod model lokalny.
Mniejsze incydenty
- Przepuściłem skrypt od worktree przez
head -1, pipe się zamknął, skrypt padł razem z nim, a każdy agent wystartował bez worktree i wrócił ze statusem BLOCKED. - Wszystkie testy były zielone, a mimo to poziom-hub jednej z gier był niegrywalny, bo testy sprawdzały tylko liczby. Uruchomienie w prawdziwym silniku po każdej partii jest teraz obowiązkowe.
- W osobnym przypadku po trzech rundach poprawek średnia ocena krytyka wciąż wynosiła 7,1 na 10. Nowy krytyk na mocniejszym modelu, zapytany, jak blisko concept artu jest wynik, dał od 4 do 5. Po dwóch albo trzech rundach decyduje teraz człowiek, a lista krytyka idzie do backlogu.
Jeśli budujesz coś podobnego
To wszystko ma tydzień. Doprowadziło jedną grę do wydania przy sześciu z ośmiu bramek pominiętych albo nadpisanych, a ja nie porównałem tego w kontrolowanych warunkach z pracą bez tego systemu, więc nie twierdzę, że jest szybciej albo taniej.
Gdybym zaczynał od nowa, najpierw zrobiłbym podkładanie bugów. Zanim zaufasz „brakowi bugów” od testera AI, podłóż znane bugi i policz, ile wraca, czytaj wynik w podziale na klasy bugów i upewnij się, że jeden podłożony bug nie może schować drugiego. To akurat zepsułem w obu przebiegach.
Daj brakowi dowodów własny werdykt i traktuj go jako gorszy niż ostrzeżenie, żeby kontrola, która się nie uruchomiła, nigdy nie mogła zostać odczytana jako zaliczona. Haszuj kryteria akceptacji w chwili ich zatwierdzania i porównuj z zatwierdzoną kopią, bo hasz zapisany obok kryteriów niczego nie chroni. Jeśli fakt jest dostępny przez API, zbieraj go skryptem, a kiedy narzędzie zawodzi, zadanie powinno się zatrzymać i to zgłosić, a nie jechać dalej z pamięci.
Koszt licz z logów sesji, razem z odczytami z cache'u. Mój dziennik ticketów widział około 5% kosztu.
Dwie rzeczy dotyczą konkretnie Claude Code. Subagent dostaje twoje pliki z instrukcjami, ten projektowy i ten osobisty, więc jeśli subagent ma coś oceniać, przeczytaj te pliki tak, jak on by je przeczytał. A w mojej konfiguracji listy narzędzi były jedyną granicą, która była wymuszana. Hooki i reguły uprawnień są następne w kolejce, a dopóki ich nie ma, wszystko inne w moich plikach ról jest prośbą.